Posts LinkedIn
Les systèmes que je construis, et la recherche derrière
Chaque post part d'une décision prise dans un système que j'ai construit ou dans une preuve que j'ai menée : ce qui a cassé, ce que j'ai changé et le chiffre obtenu ensuite.
-
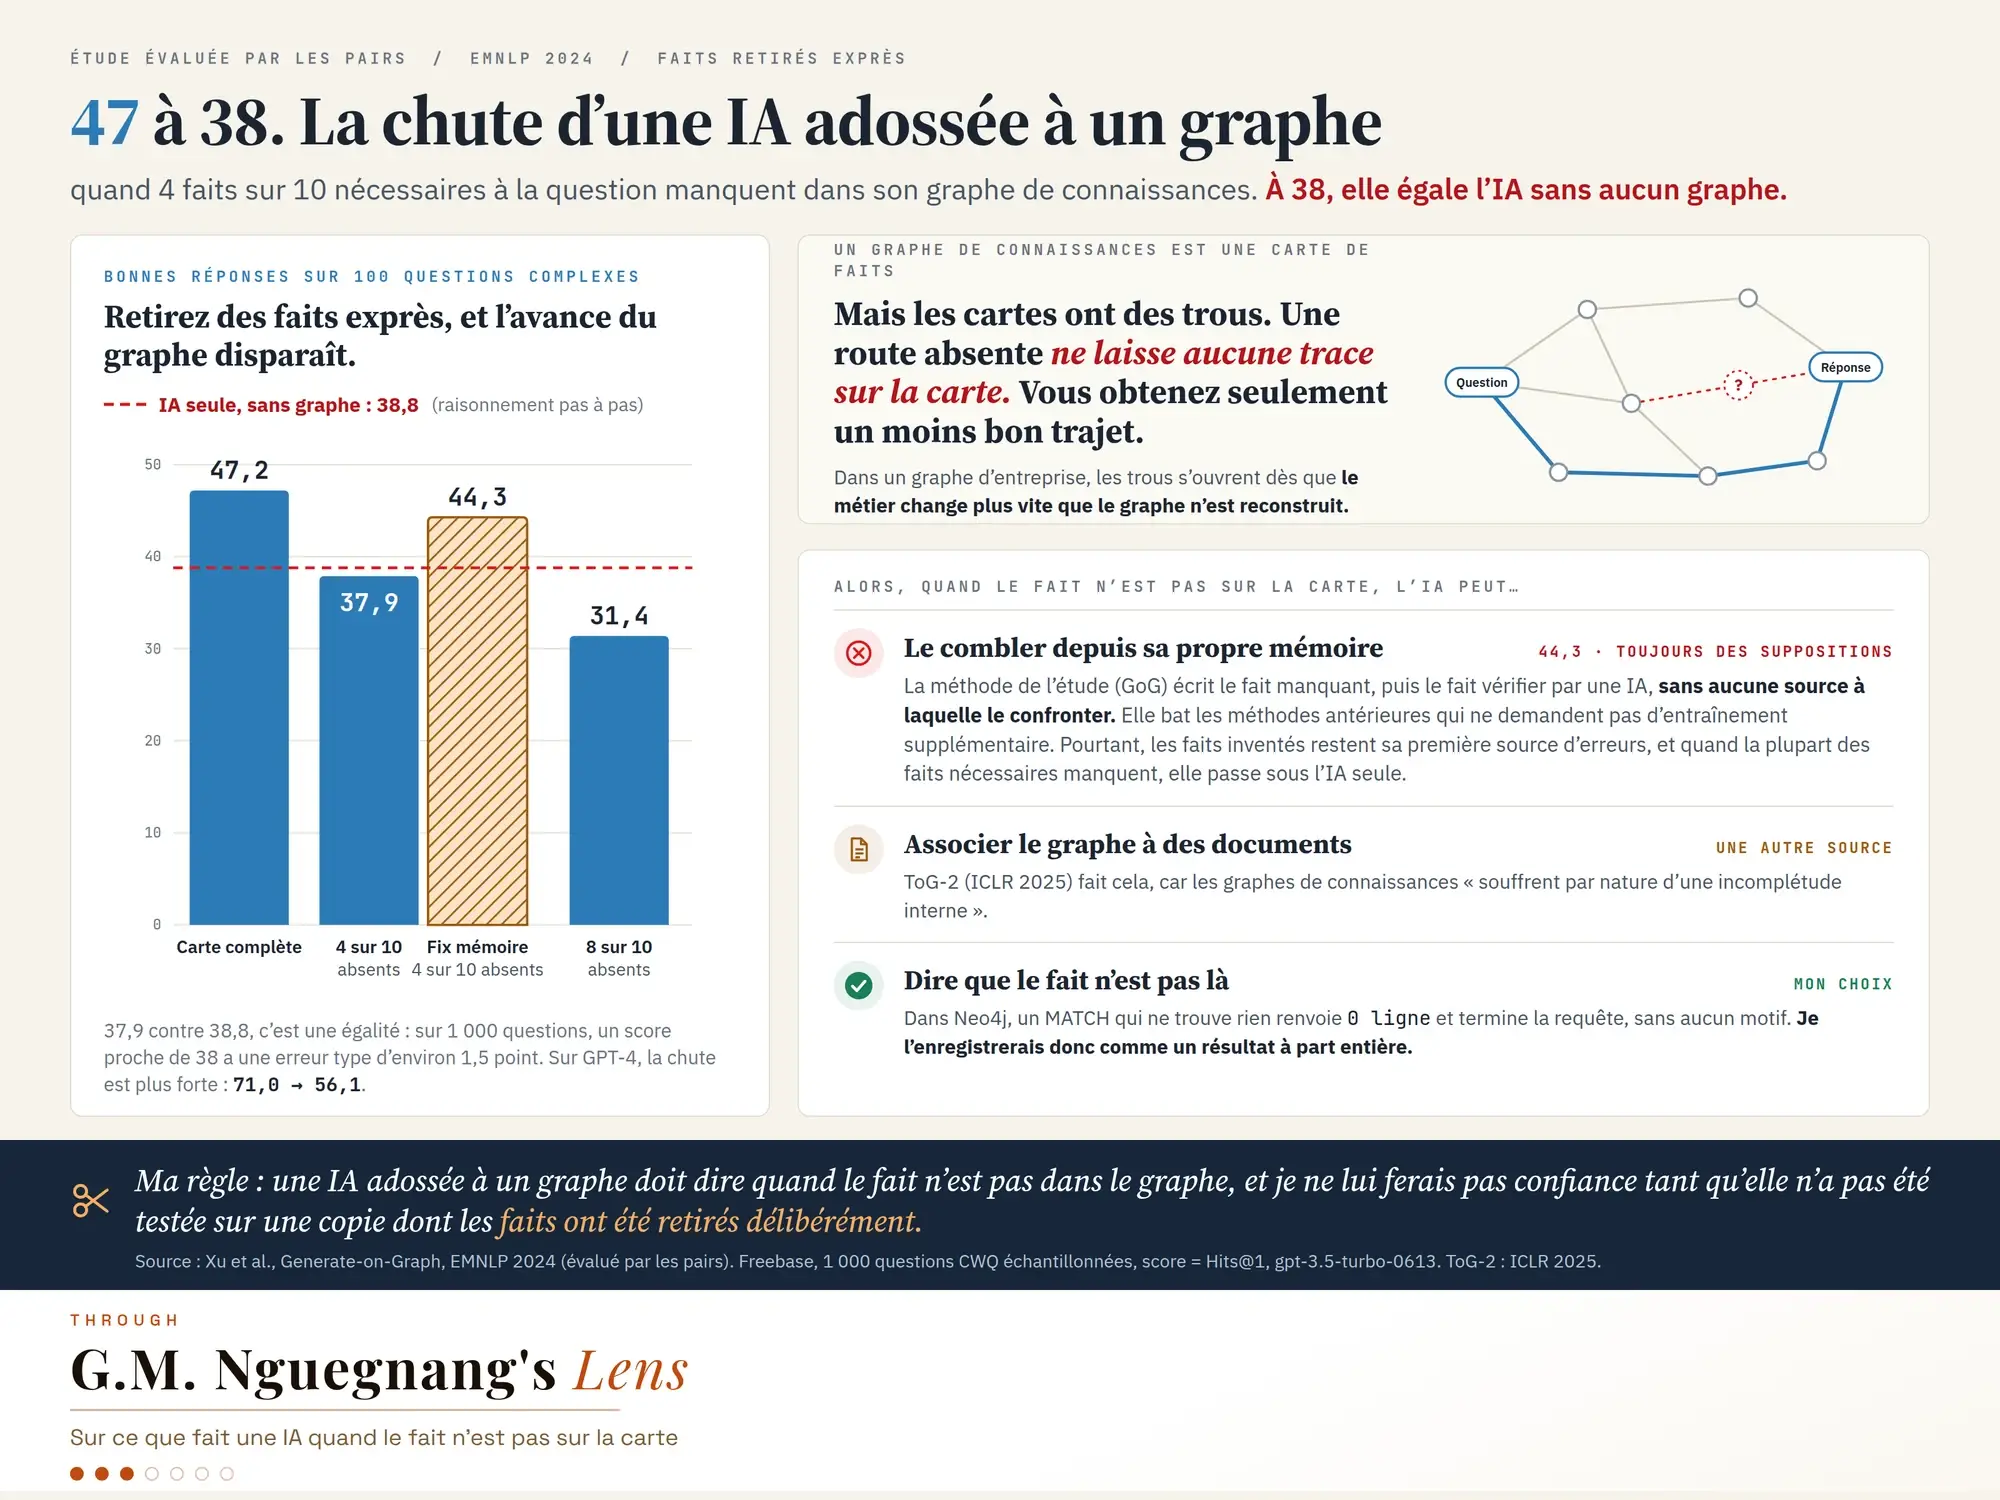
47 à 38 : la chute d'une IA adossée à un graphe privé de faits
Une étude évaluée par les pairs a retiré des faits d'un graphe de connaissances, exprès. Avec 4 des faits nécessaires sur 10 manquants, le système adossé au graphe obtient le score du modèle sans aucun graphe.
-
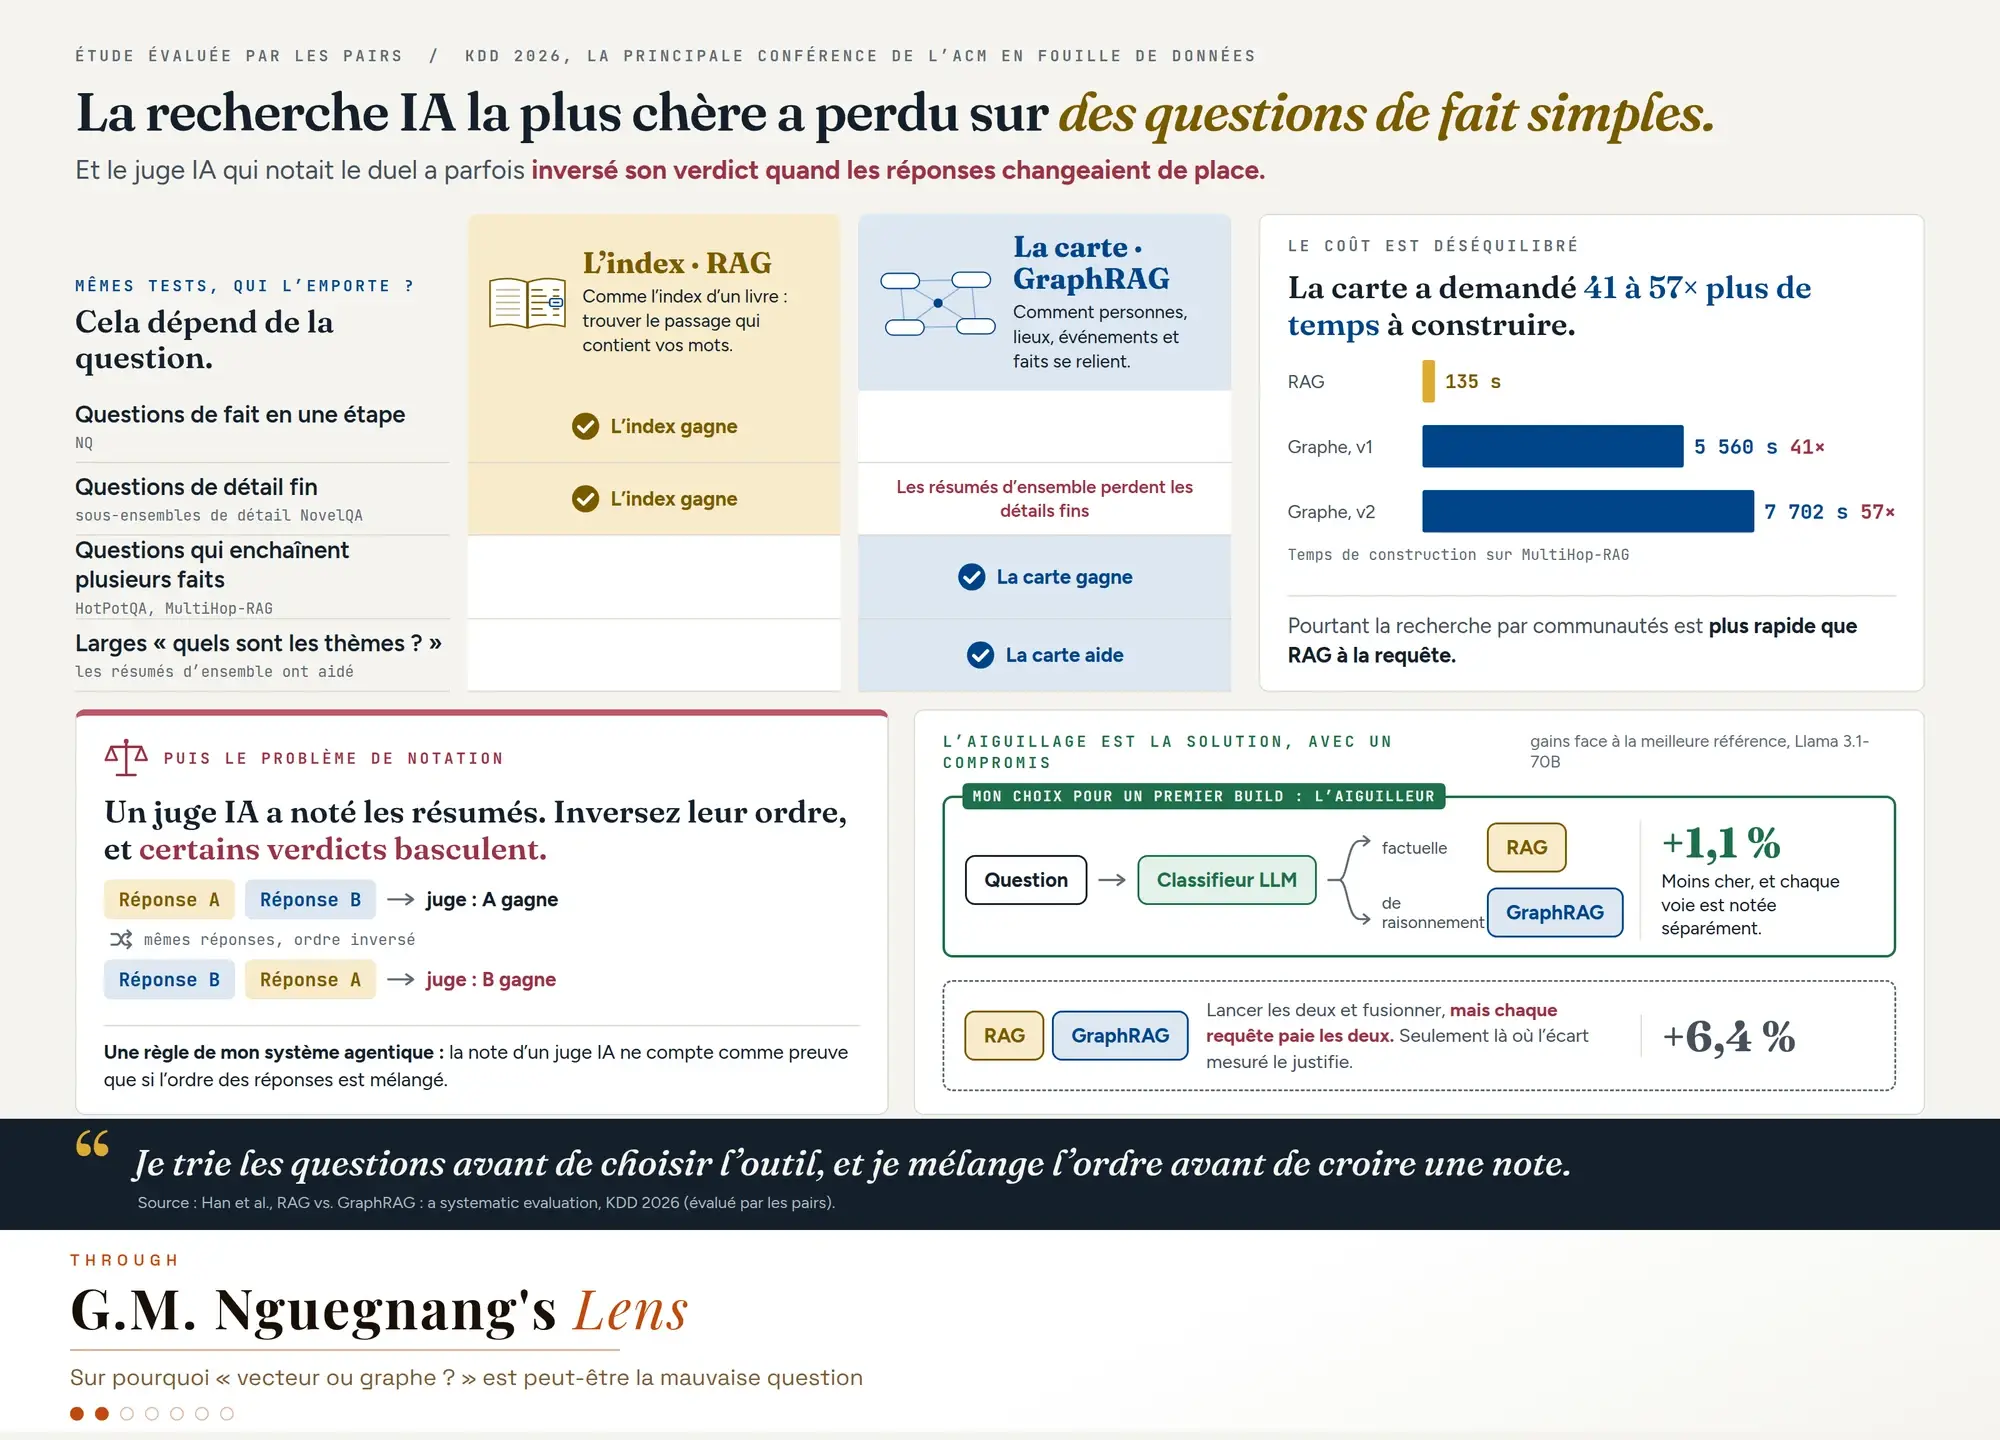
La recherche IA la plus coûteuse a perdu sur des questions simples
Une étude évaluée par les pairs à KDD 2026 a soumis la recherche classique et la recherche par graphe aux mêmes tests. Le gagnant dépendait de la question, et le juge IA qui notait le duel a parfois inversé son verdict quand les réponses changeaient de place.
-
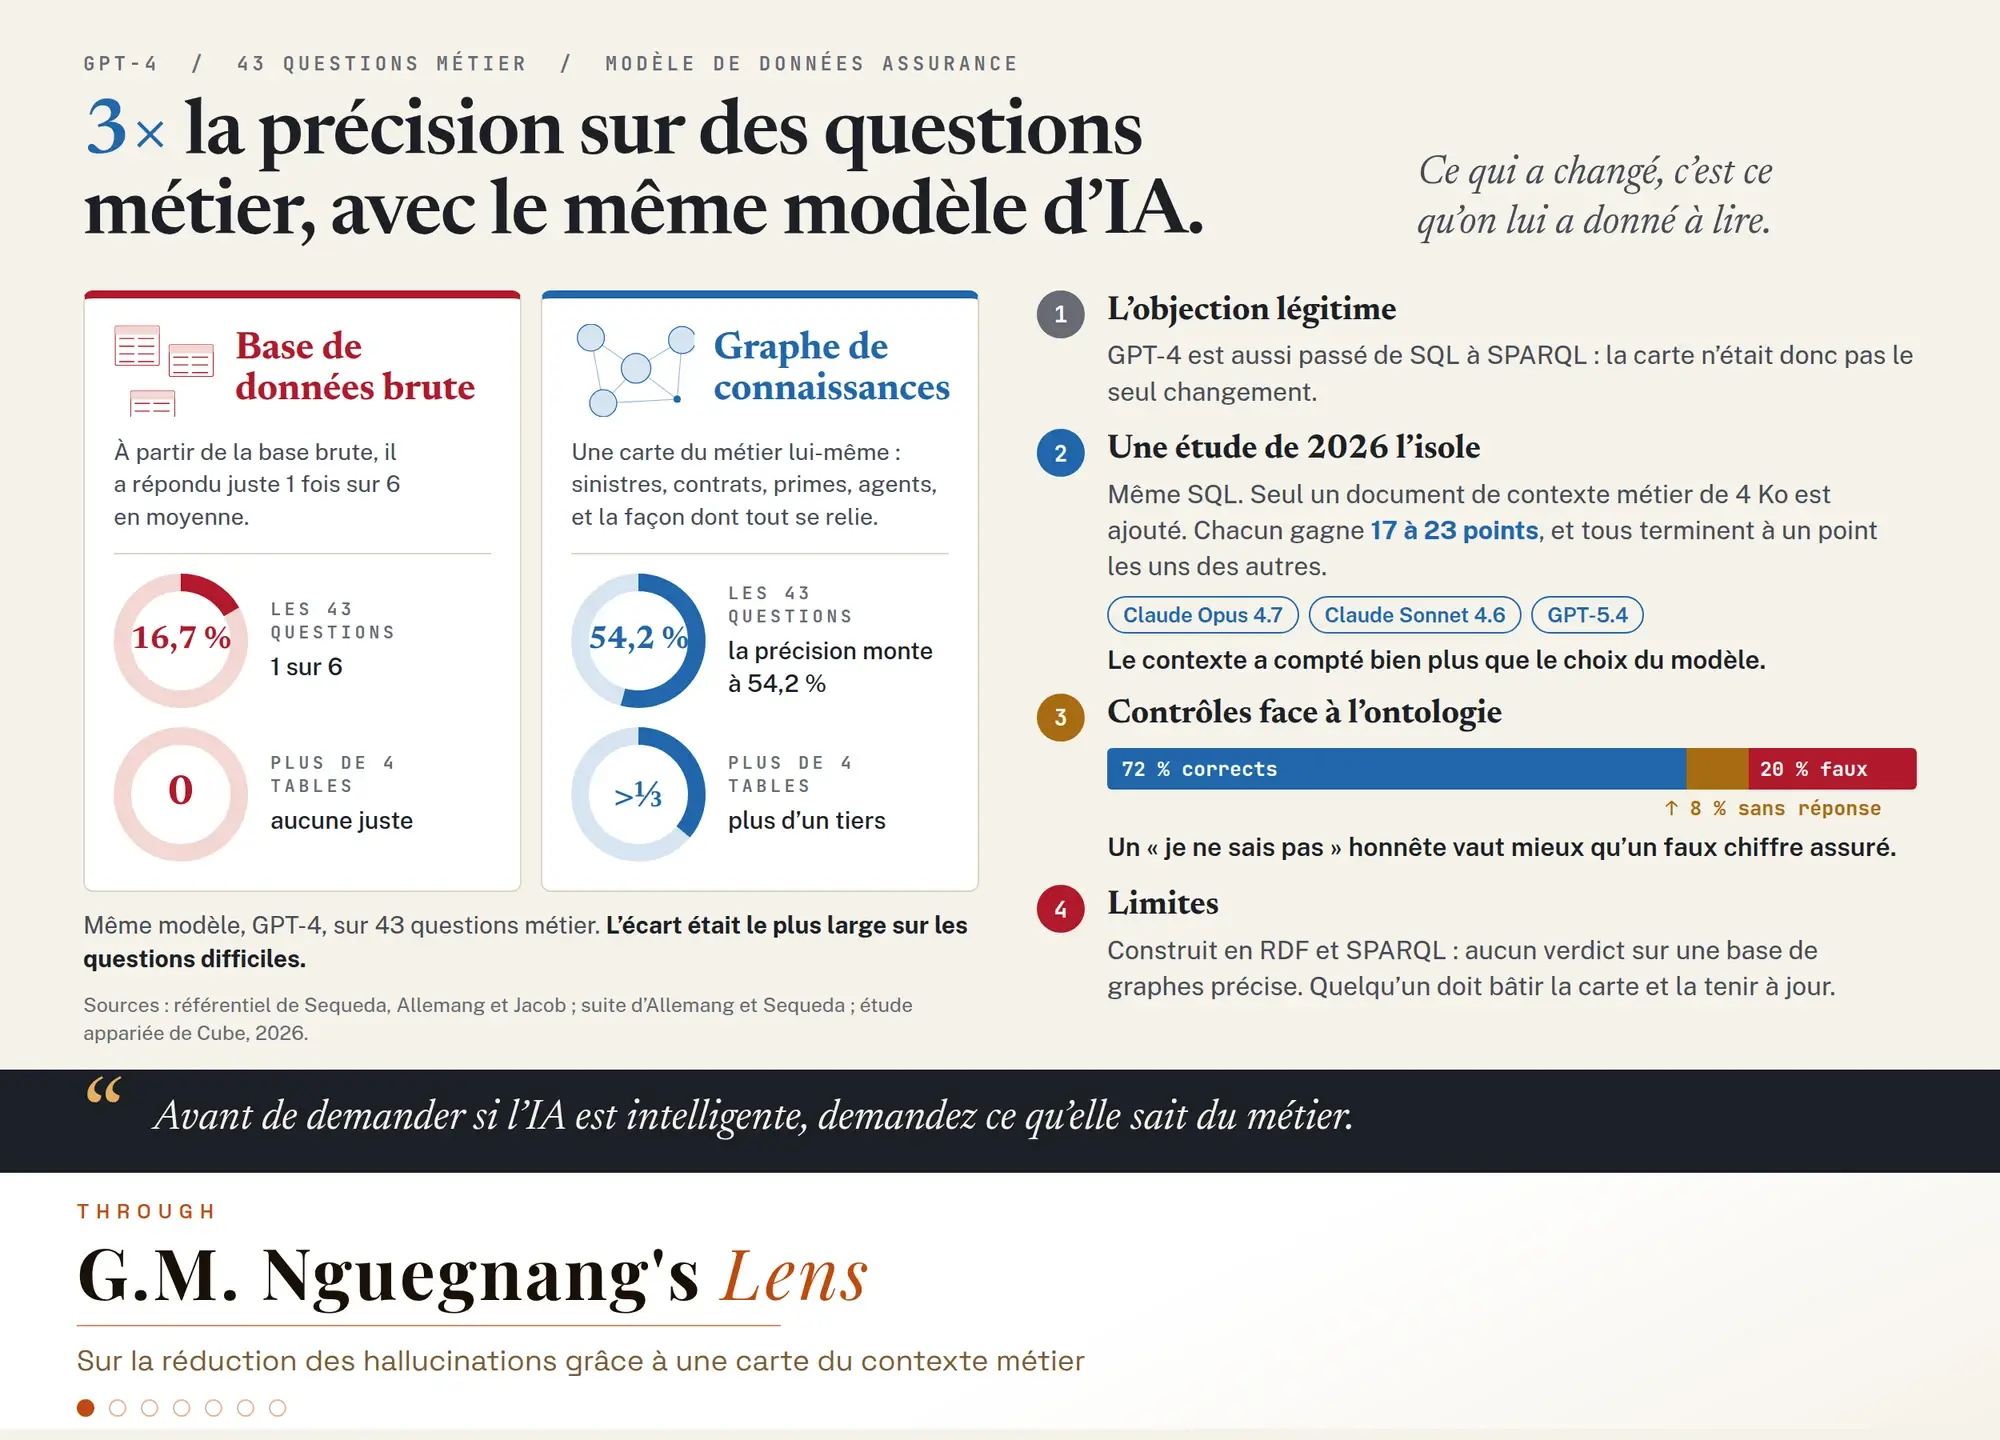
3× la précision sur des questions métier, avec le même modèle
Des chercheurs ont posé 43 questions métier à GPT-4 sur un modèle de données d'assurance standard. Ce qui a fait passer la précision de 16,7 % à 54,2 % n'est pas le modèle. C'est ce qu'on lui a donné à lire.
-
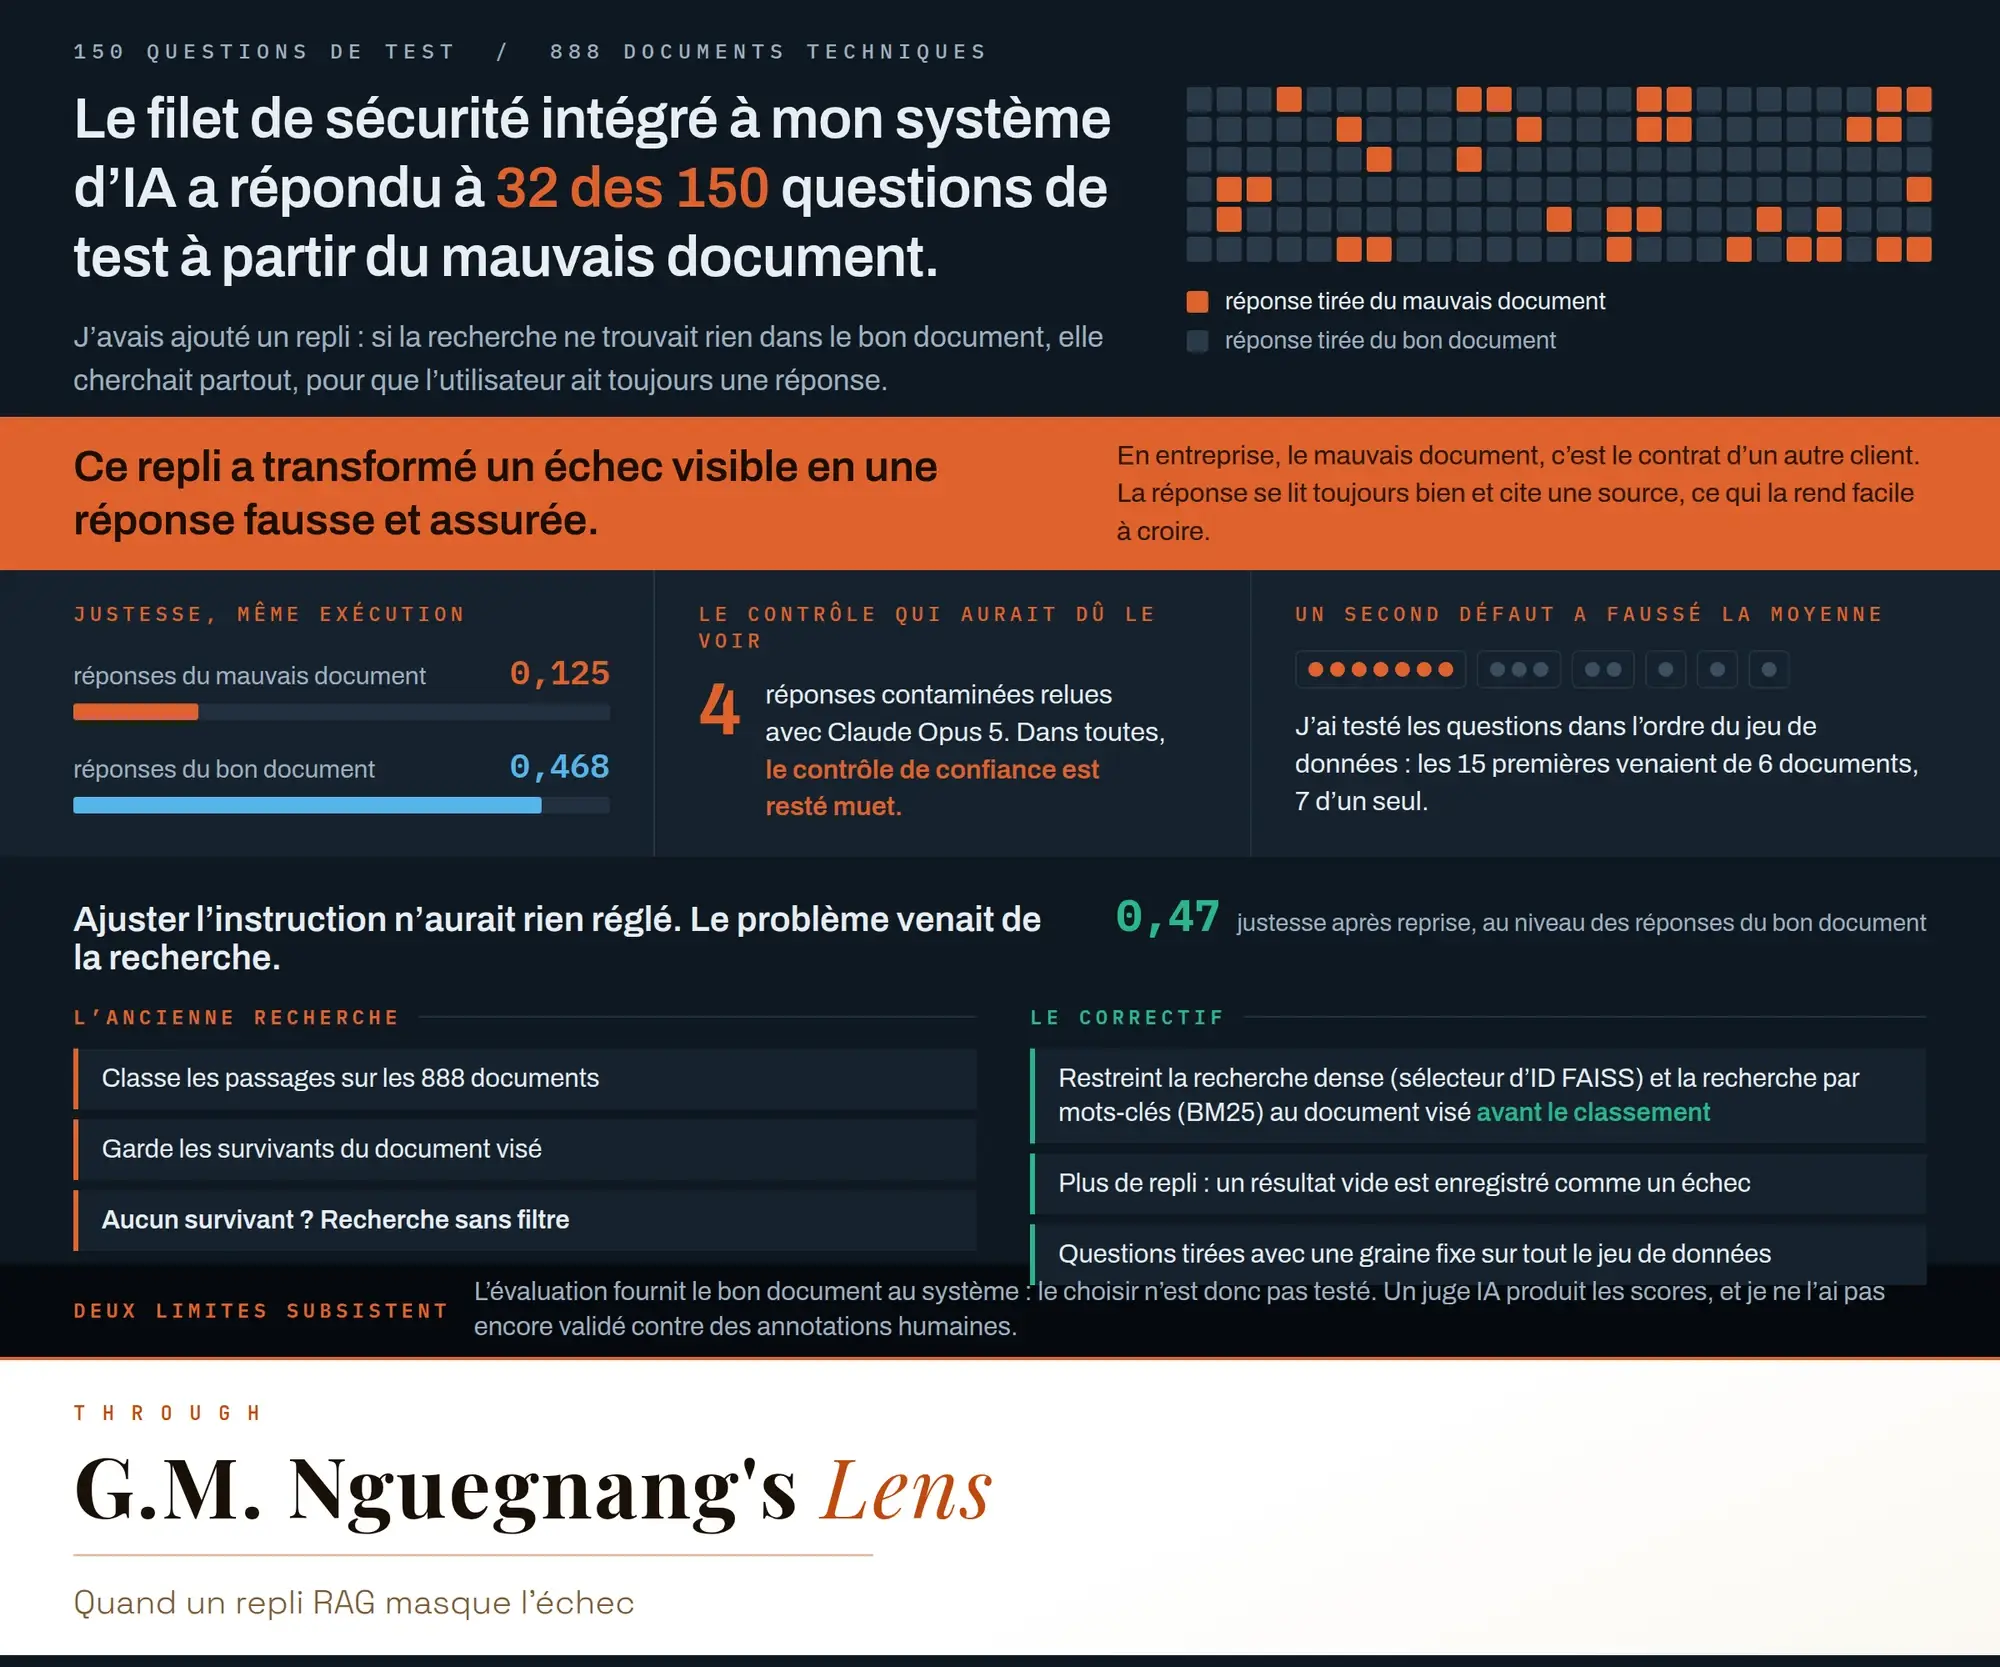
Le filet de sécurité a répondu à 32 des 150 questions depuis le mauvais document
Si la recherche ne trouvait rien dans le bon document, mon système cherchait partout, pour que l'utilisateur ait toujours une réponse. Ce repli a transformé un échec visible en une réponse fausse et assurée.
-
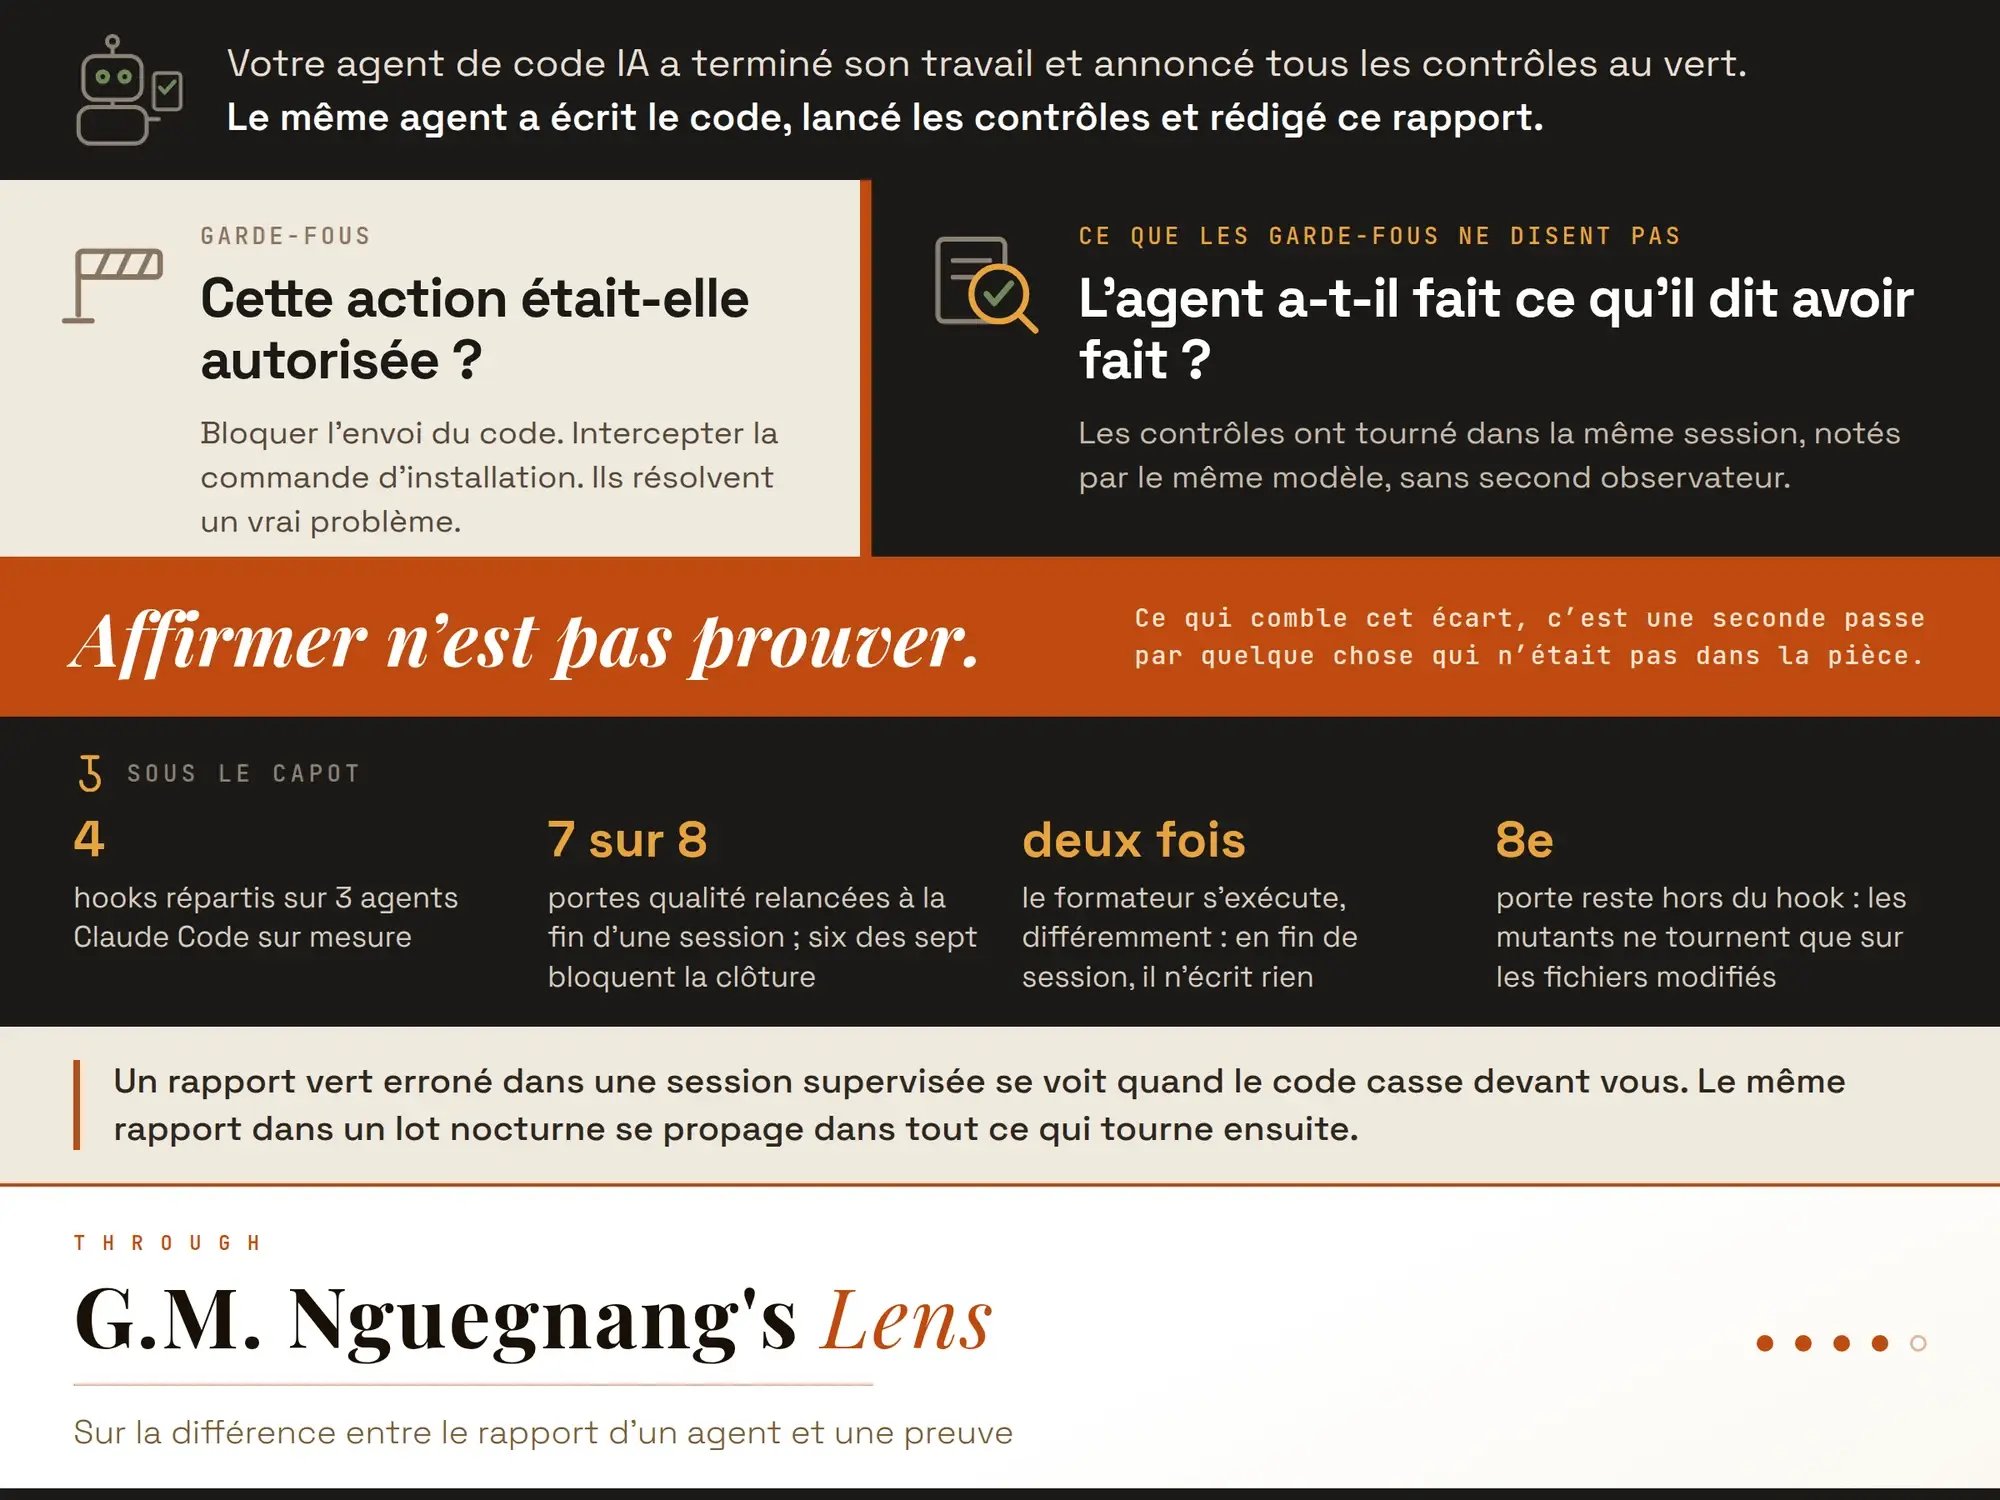
L'agent a lancé les contrôles, et rédigé le rapport disant qu'ils passaient
Les garde-fous disent si une action était autorisée. Ils ne disent pas si l'agent a fait ce qu'il prétend avoir fait. Un hook de fin de session relance sept des huit portes, et le résumé de l'agent cesse d'être le compte rendu.
-
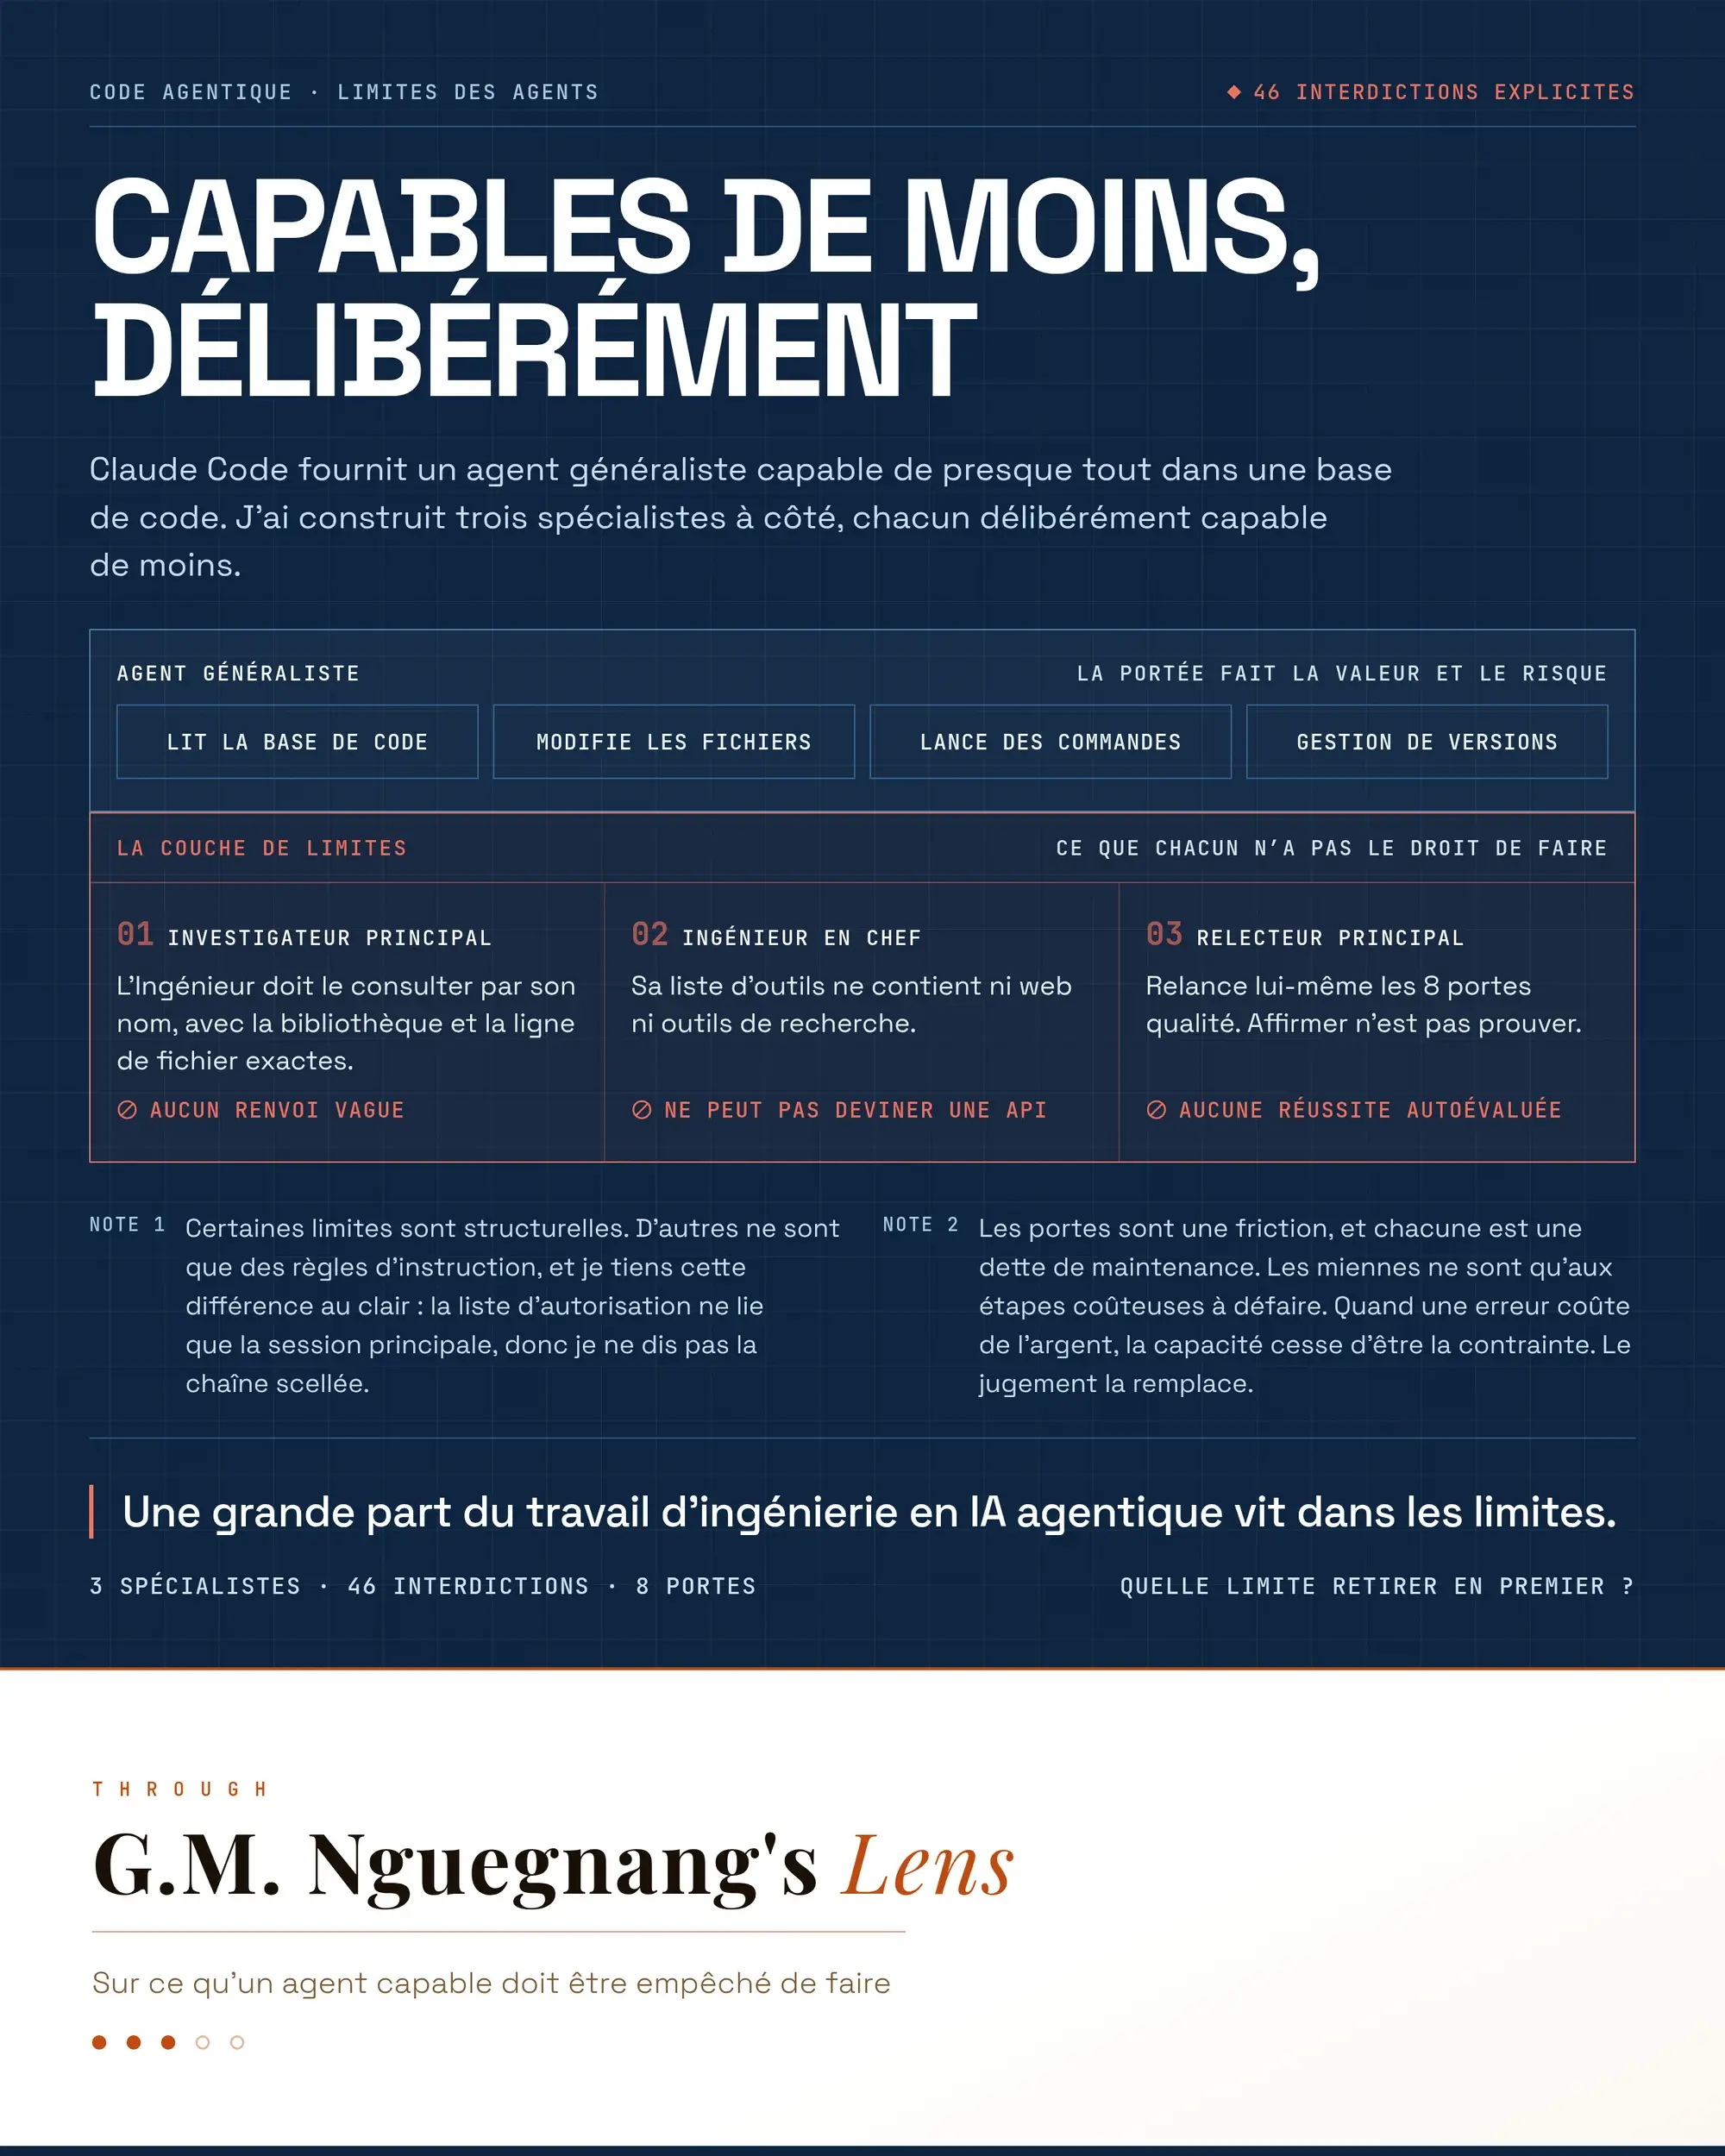
J'ai donné moins de capacités à trois agents de code, délibérément
Claude Code fournit un agent généraliste capable de presque tout dans une base de code. J'en fais tourner trois spécialistes à côté, avec 46 interdictions explicites entre eux, parce que quand une erreur coûte de l'argent, la capacité cesse d'être la contrainte.
-
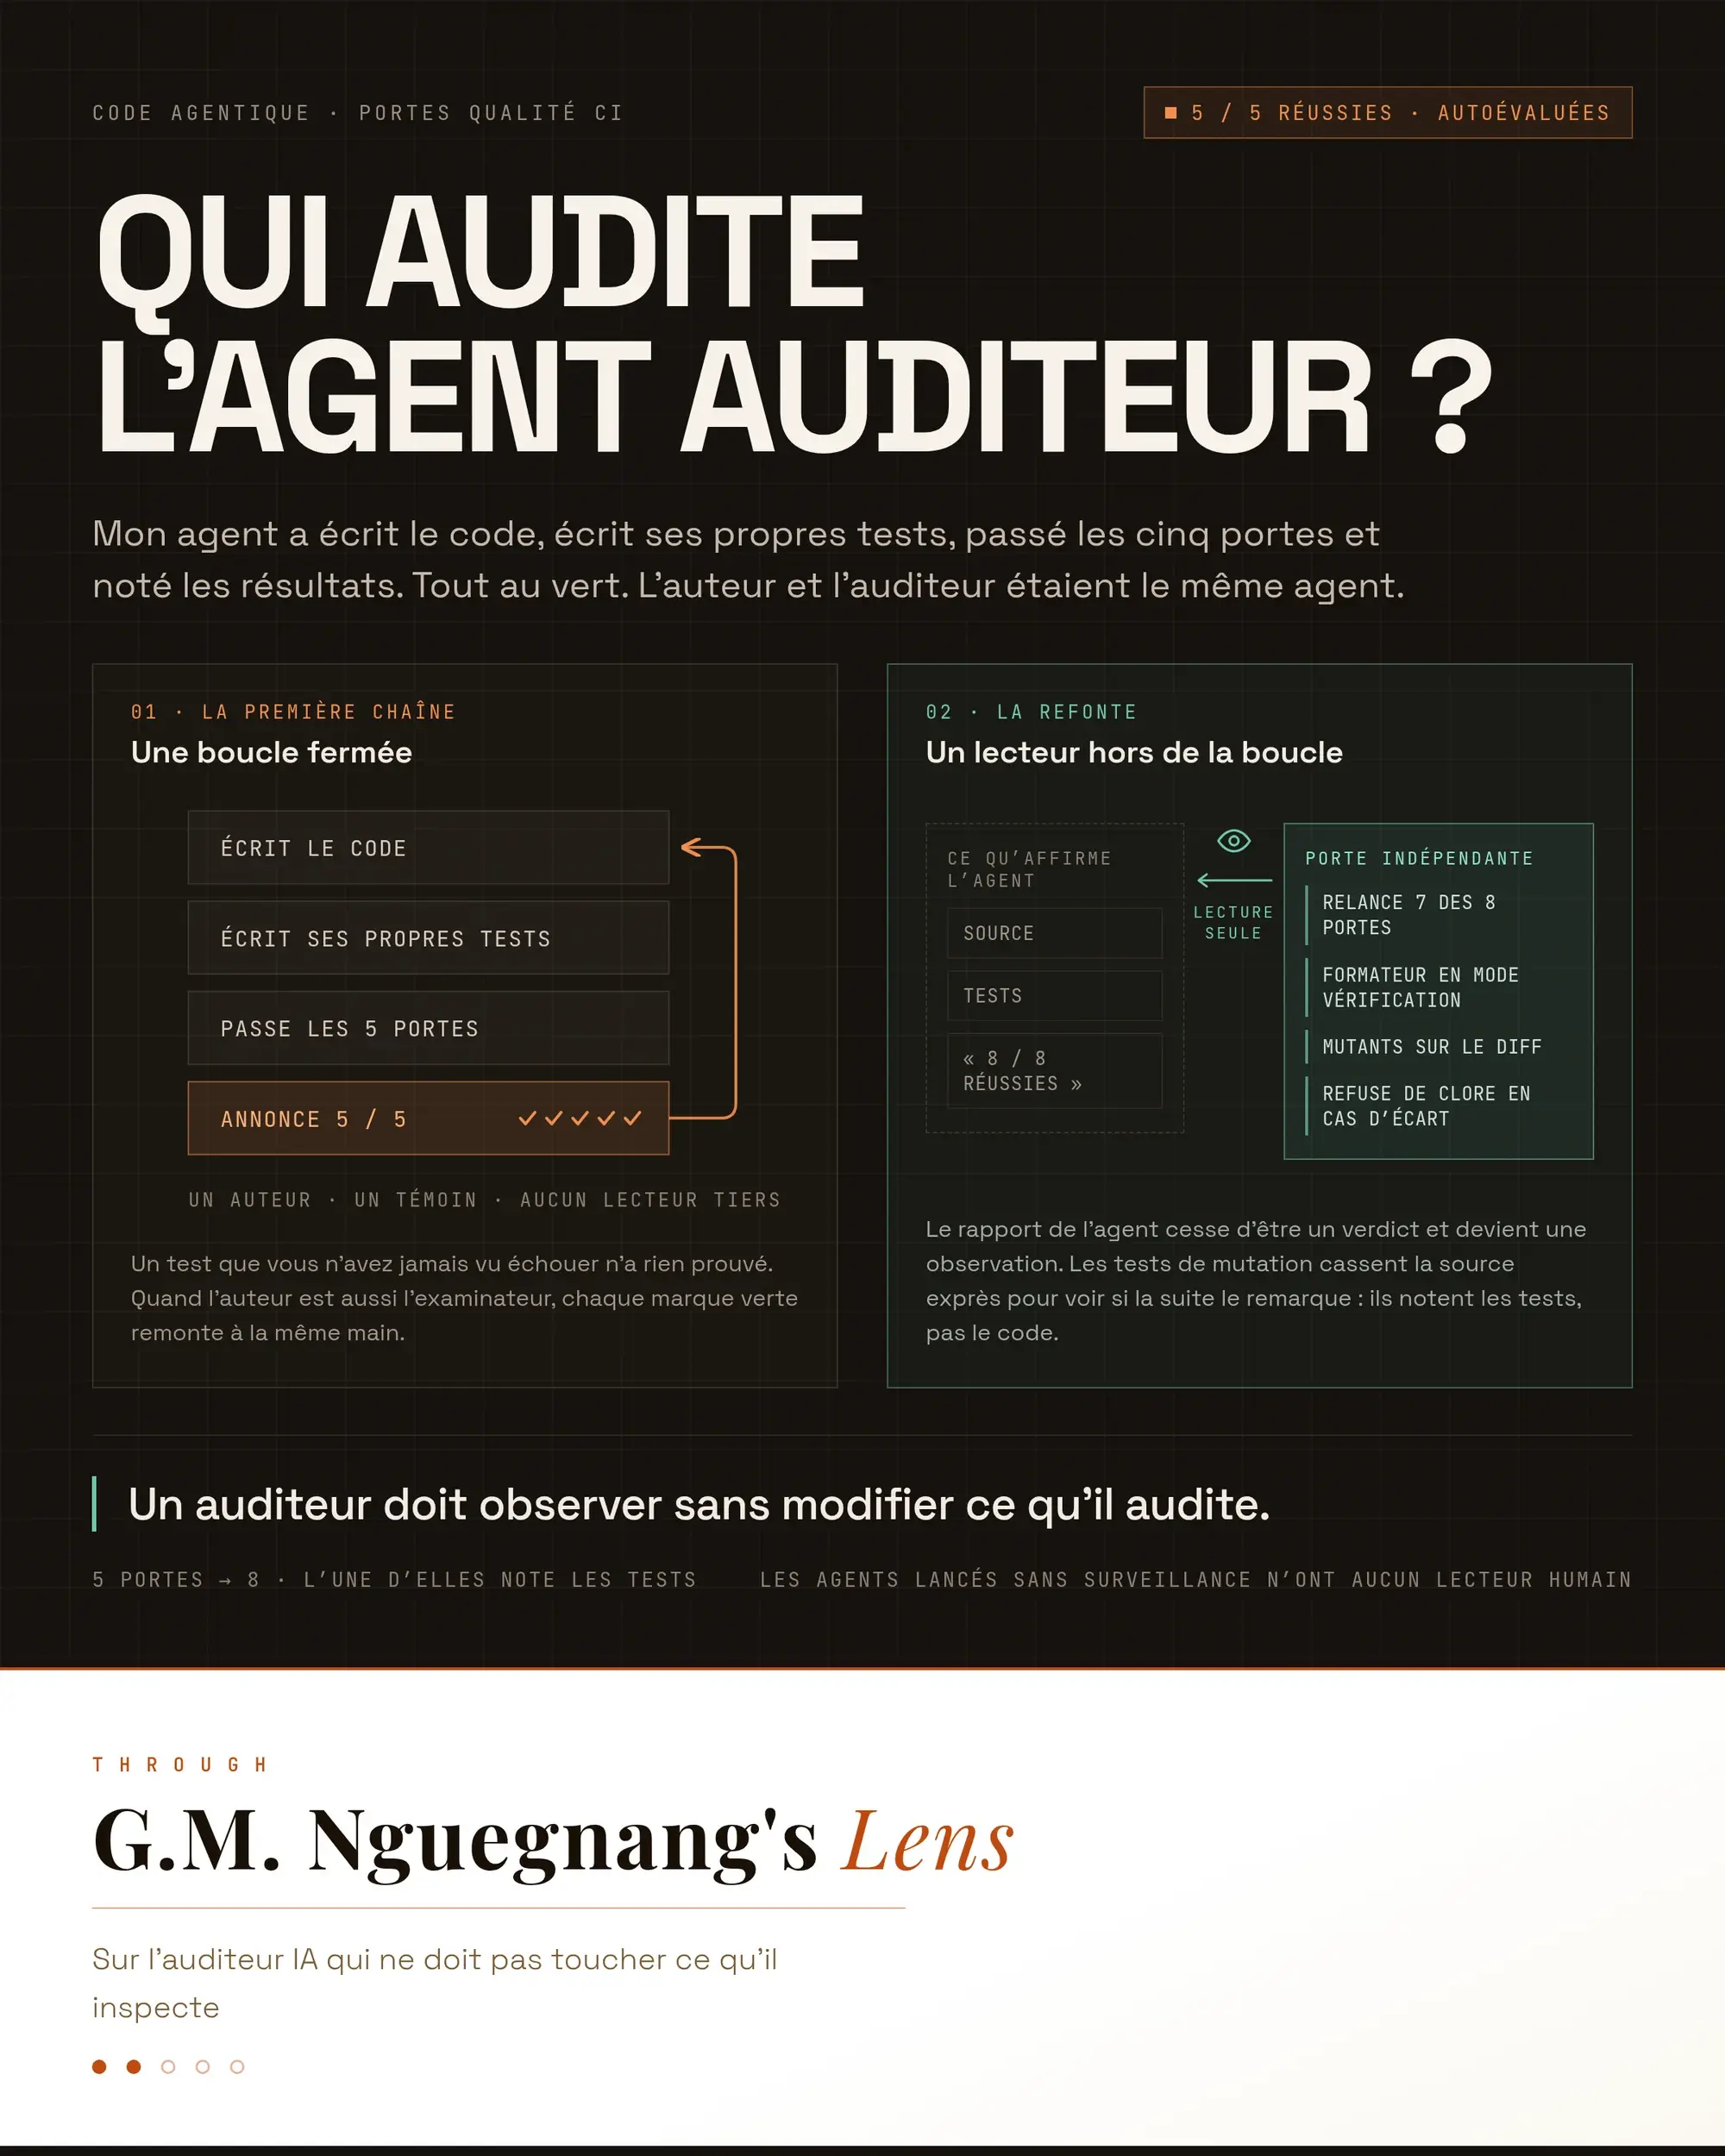
Cinq portes qualité franchies, notées par l'agent qui avait écrit le code
L'agent a écrit le code, écrit ses tests, lancé les contrôles et annoncé cinq feux verts. Rien dans la chaîne n'était prévu pour demander qui contrôle le contrôleur.
-
Ai-je une garantie, ou est-ce que je devine ?
L'analyse de convergence m'a appris à poser une seule question à tout algorithme. Cette question a façonné un système agentique d'approvisionnement construit pour décider quand ne pas croire ses propres réponses.
-
Une instruction réglée à la main obtient 91 %. Une instruction compilée obtient 99 %.
Orientez mal une question d'approvisionnement et une demande de stock revient avec une réponse de tournées de véhicules. J'ai remplacé l'instruction de classification écrite à la main par une instruction compilée avec DSPy, puis j'ai passé plus de temps sur la mesure que sur la compilation.
-
Même question, chiffres différents, mauvaise réponse
« Allouer 400 unités » et « allouer 1 000 unités » produisent des vecteurs presque identiques. Un cache qui ne s'appuie que sur la similarité servira à un responsable les chiffres d'un autre.
-
Pourquoi nous avons prouvé la convergence sur le réseau le plus simple qui soit
La couche linéaire est le seul composant que tous les réseaux de neurones partagent. Sa perte reste non convexe, et son entraînement reste NP-complet. C'est pour cela que c'est le bon endroit où chercher une garantie.
-
J'ai soutenu ma thèse : analyse de convergence de l'entraînement des réseaux de neurones linéaires profonds
Le taux d'apprentissage dépend de constantes que la théorie existante ne sait pas calculer avant l'entraînement, donc on les choisit par tâtonnement. J'ai refermé une partie de cet écart, et j'applique aujourd'hui la même rigueur à l'IA en production.
-
Le copilote continue de répondre quand le modèle de langage s'éteint
Une offre gratuite plafonnée à 50 appels d'API par jour a dicté chaque décision de conception de ce système. La contrainte a disparu. L'architecture qu'elle a produite est restée, parce qu'elle a gagné sa place.
-
La partie la plus fiable du copilote est celle que le modèle de langage ne touche jamais
Demandez à un modèle de langage de planifier une décision logistique et vous obtenez la réponse la plus probable statistiquement, pas la moins chère. J'ai donc gardé le modèle hors du calcul et mis l'effort sur la frontière entre les deux.
-
10 000 $, c'est là que l'agent s'arrête et qu'un humain décide
Tout circuit d'approbation a besoin d'un montant. En dessous, l'agent exécute. Au-dessus, une personne signe. Le bogue qui m'a appris où placer ce contrôle n'est apparu qu'aux tests d'intégration.