47 à 38 : la chute d'une IA adossée à un graphe privé de faits
Une étude évaluée par les pairs a retiré des faits d'un graphe de connaissances, exprès. Avec 4 des faits nécessaires sur 10 manquants, le système adossé au graphe obtient le score du modèle sans aucun graphe.
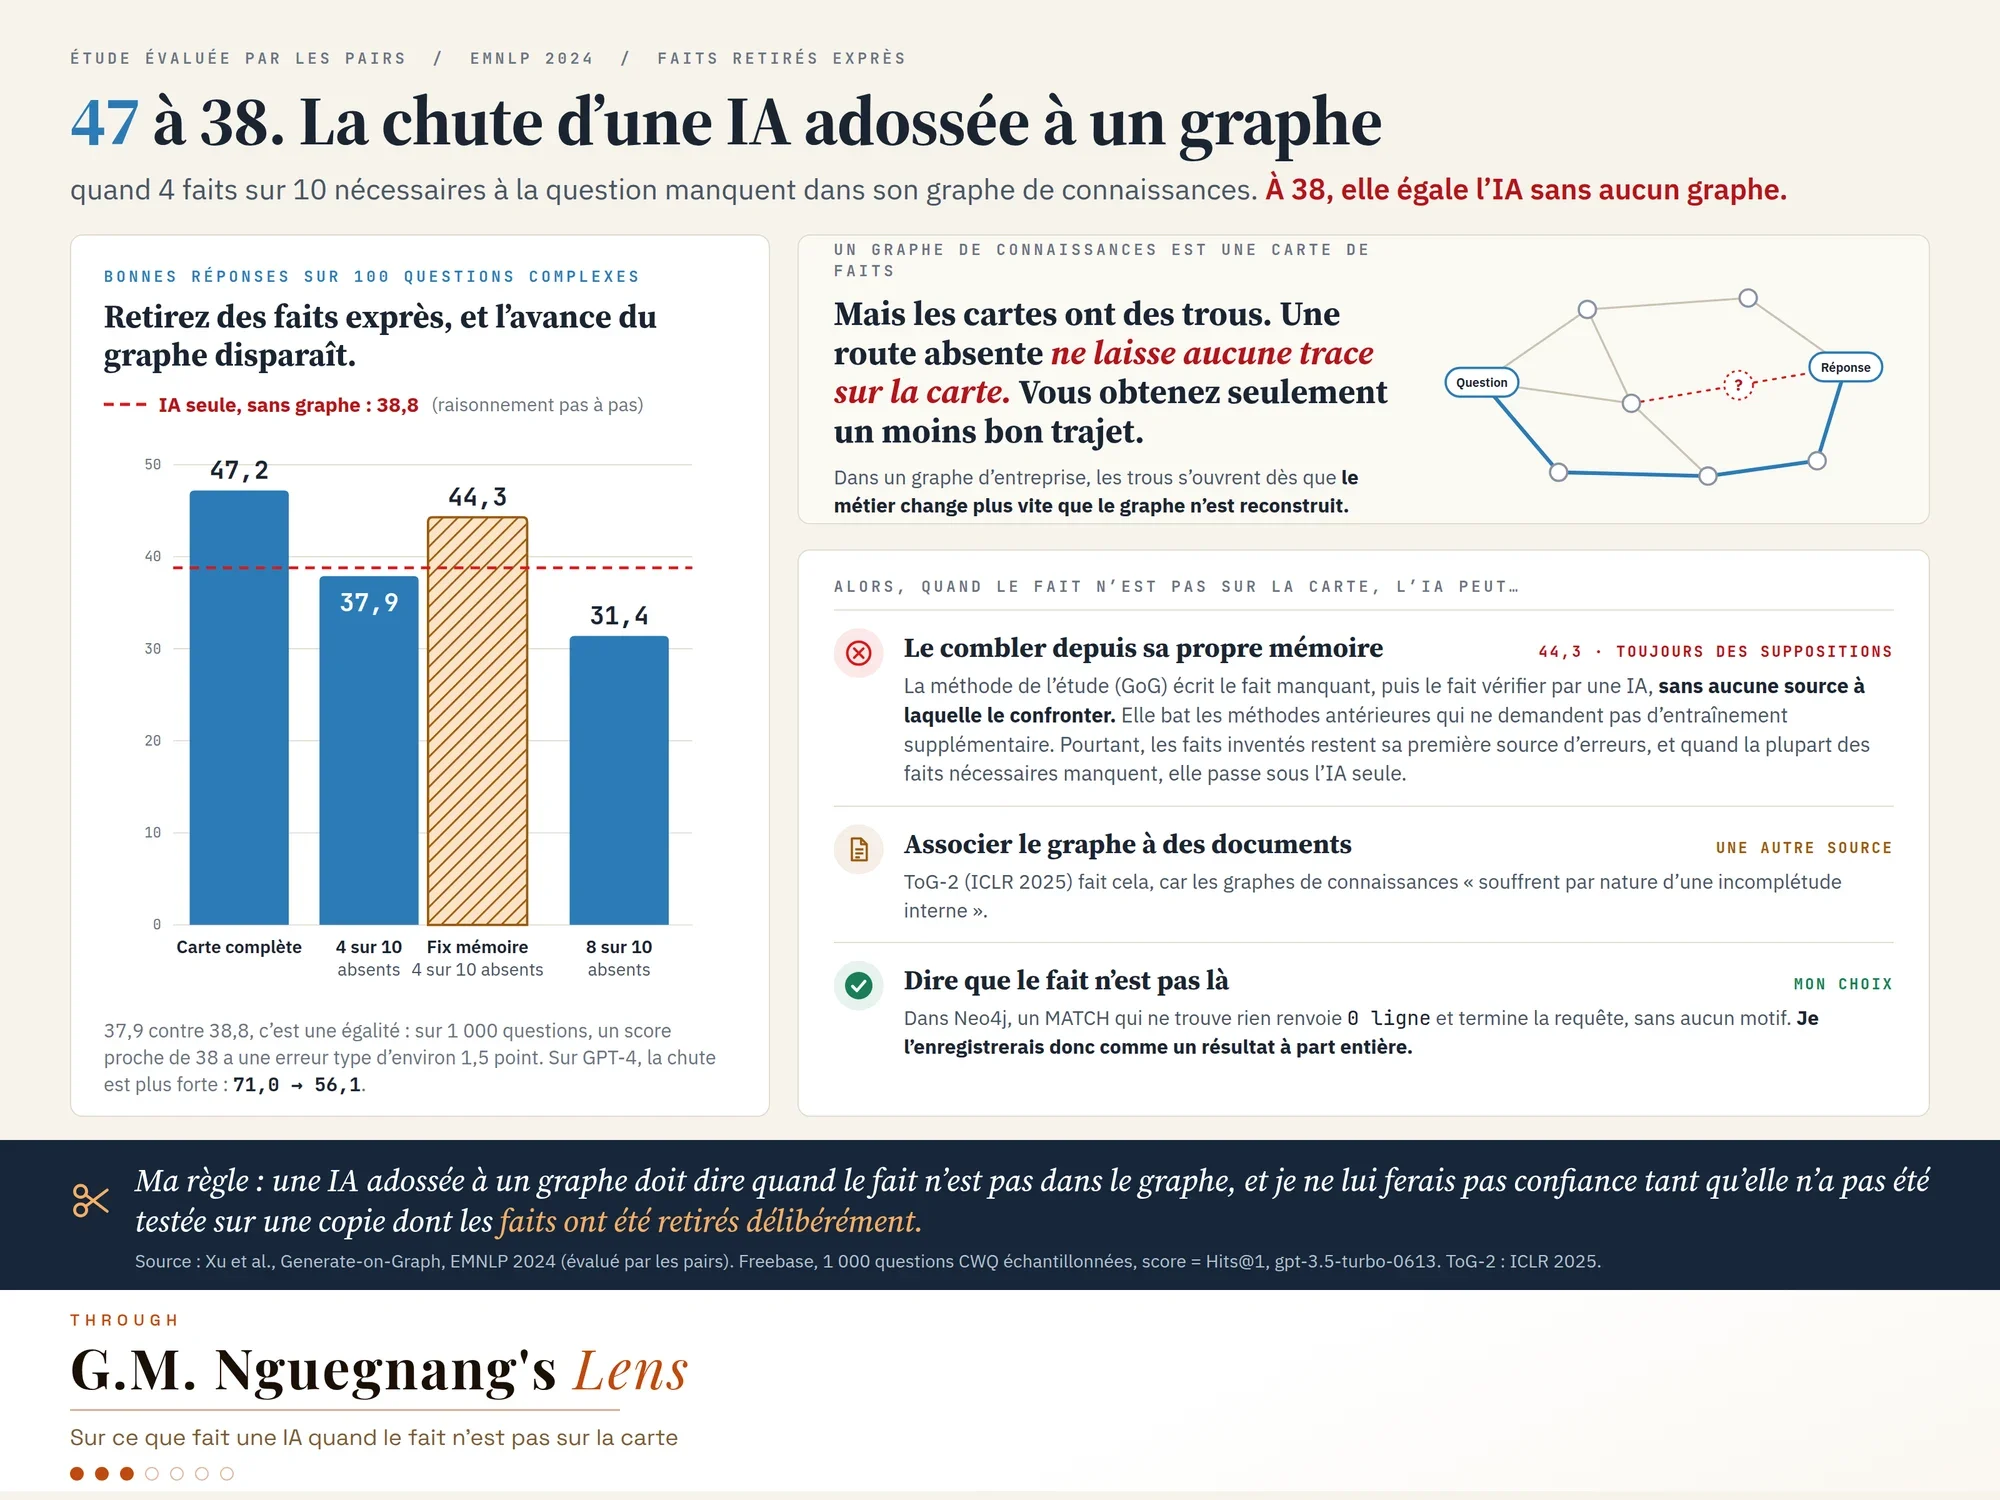
47 à 38. Voilà la chute d’une IA adossée à un graphe quand 4 des 10 faits nécessaires à chaque question disparaissent de son graphe de connaissances. À 38, elle rejoint l’IA qui travaille sans aucun graphe.
Pourquoi cela compte
Un graphe de connaissances est une carte de faits et de leurs liens. La promesse est que l’IA réponde depuis la carte au lieu de deviner.
Mais les cartes ont des trous. Une route absente ne laisse aucune trace sur la carte. Vous obtenez seulement un moins bon trajet. Dans un graphe d’entreprise, les trous s’ouvrent dès que le métier change plus vite que le graphe n’est reconstruit.
Une étude évaluée par les pairs a retiré des faits exprès. Une méthode à graphe antérieure obtenait environ 47 bonnes réponses sur 100 questions complexes avec la carte complète, et 38 avec 4 des faits clés sur 10 retirés. L’IA seule, raisonnant pas à pas, obtenait 39.
La méthode propre à l’étude comble un fait manquant depuis la mémoire de l’IA, puis le fait vérifier par une IA, sans aucune source à laquelle le confronter. Elle bat les méthodes antérieures qui ne demandent pas d’entraînement supplémentaire. Pourtant, les faits inventés restent sa première source d’erreurs, et quand la plupart des faits nécessaires manquent, elle passe sous l’IA seule.
Ma règle après cette lecture : une IA adossée à un graphe doit dire quand le fait n’est pas dans le graphe, et je ne lui ferais pas confiance tant qu’elle n’a pas été testée sur une copie dont les faits ont été retirés délibérément.
Comment cela fonctionne
Generate-on-Graph (EMNLP 2024) a retiré de 20 % à 80 % des triplets cruciaux sur le chemin de relations de référence de chaque question, sur Freebase, pour 1 000 questions CWQ et WebQSP échantillonnées.
Sur CWQ Hits@1, Think-on-Graph obtient 47,2 avec le graphe complet, 37,9 à 40 % de retrait et 31,4 à 80 %, sur gpt-3.5-turbo-0613. Sur gpt-4-0613, la chute est plus forte : 71,0 à 56,1. Le raisonnement en chaîne sans aucun graphe obtient 38,8.
Comment je lis 37,9 face à 38,8 : une égalité. Sur 1 000 questions, un score proche de 38 porte une erreur type d’environ 1,5 point. Les chiffres du raisonnement en chaîne correspondent aussi exactement aux valeurs ChatGPT du papier ToG, ils viennent donc peut-être d’une autre exécution.
GoG fait générer les triplets manquants par le modèle, puis les fait vérifier, ce qui atteint 44,3 à 40 % de retrait. Sa propre section Limitations concède l’hallucination à cette étape et un score inférieur au raisonnement en chaîne sur des graphes très incomplets. ToG-2 (ICLR 2025) associe plutôt le graphe à des documents, puisque les graphes de connaissances « souffrent par nature d’une incomplétude interne ».
La conséquence d’ingénierie se situe une couche plus bas. Dans Neo4j, un MATCH qui ne trouve rien ne renvoie aucune ligne et termine la requête. Un résultat vide n’emporte aucun motif avec lui, et c’est précisément le signal dont l’appelant a besoin : je l’enregistrerais donc comme un résultat à part entière plutôt que de le laisser passer pour un silence.