47 auf 38: So tief fiel eine graphgestützte KI ohne ihre Fakten
Eine begutachtete Studie entfernte absichtlich Fakten aus einem Wissensgraphen. Mit 4 von 10 benötigten Fakten weniger erreichte das graphgestützte System genau den Wert des Modells ganz ohne Graph.
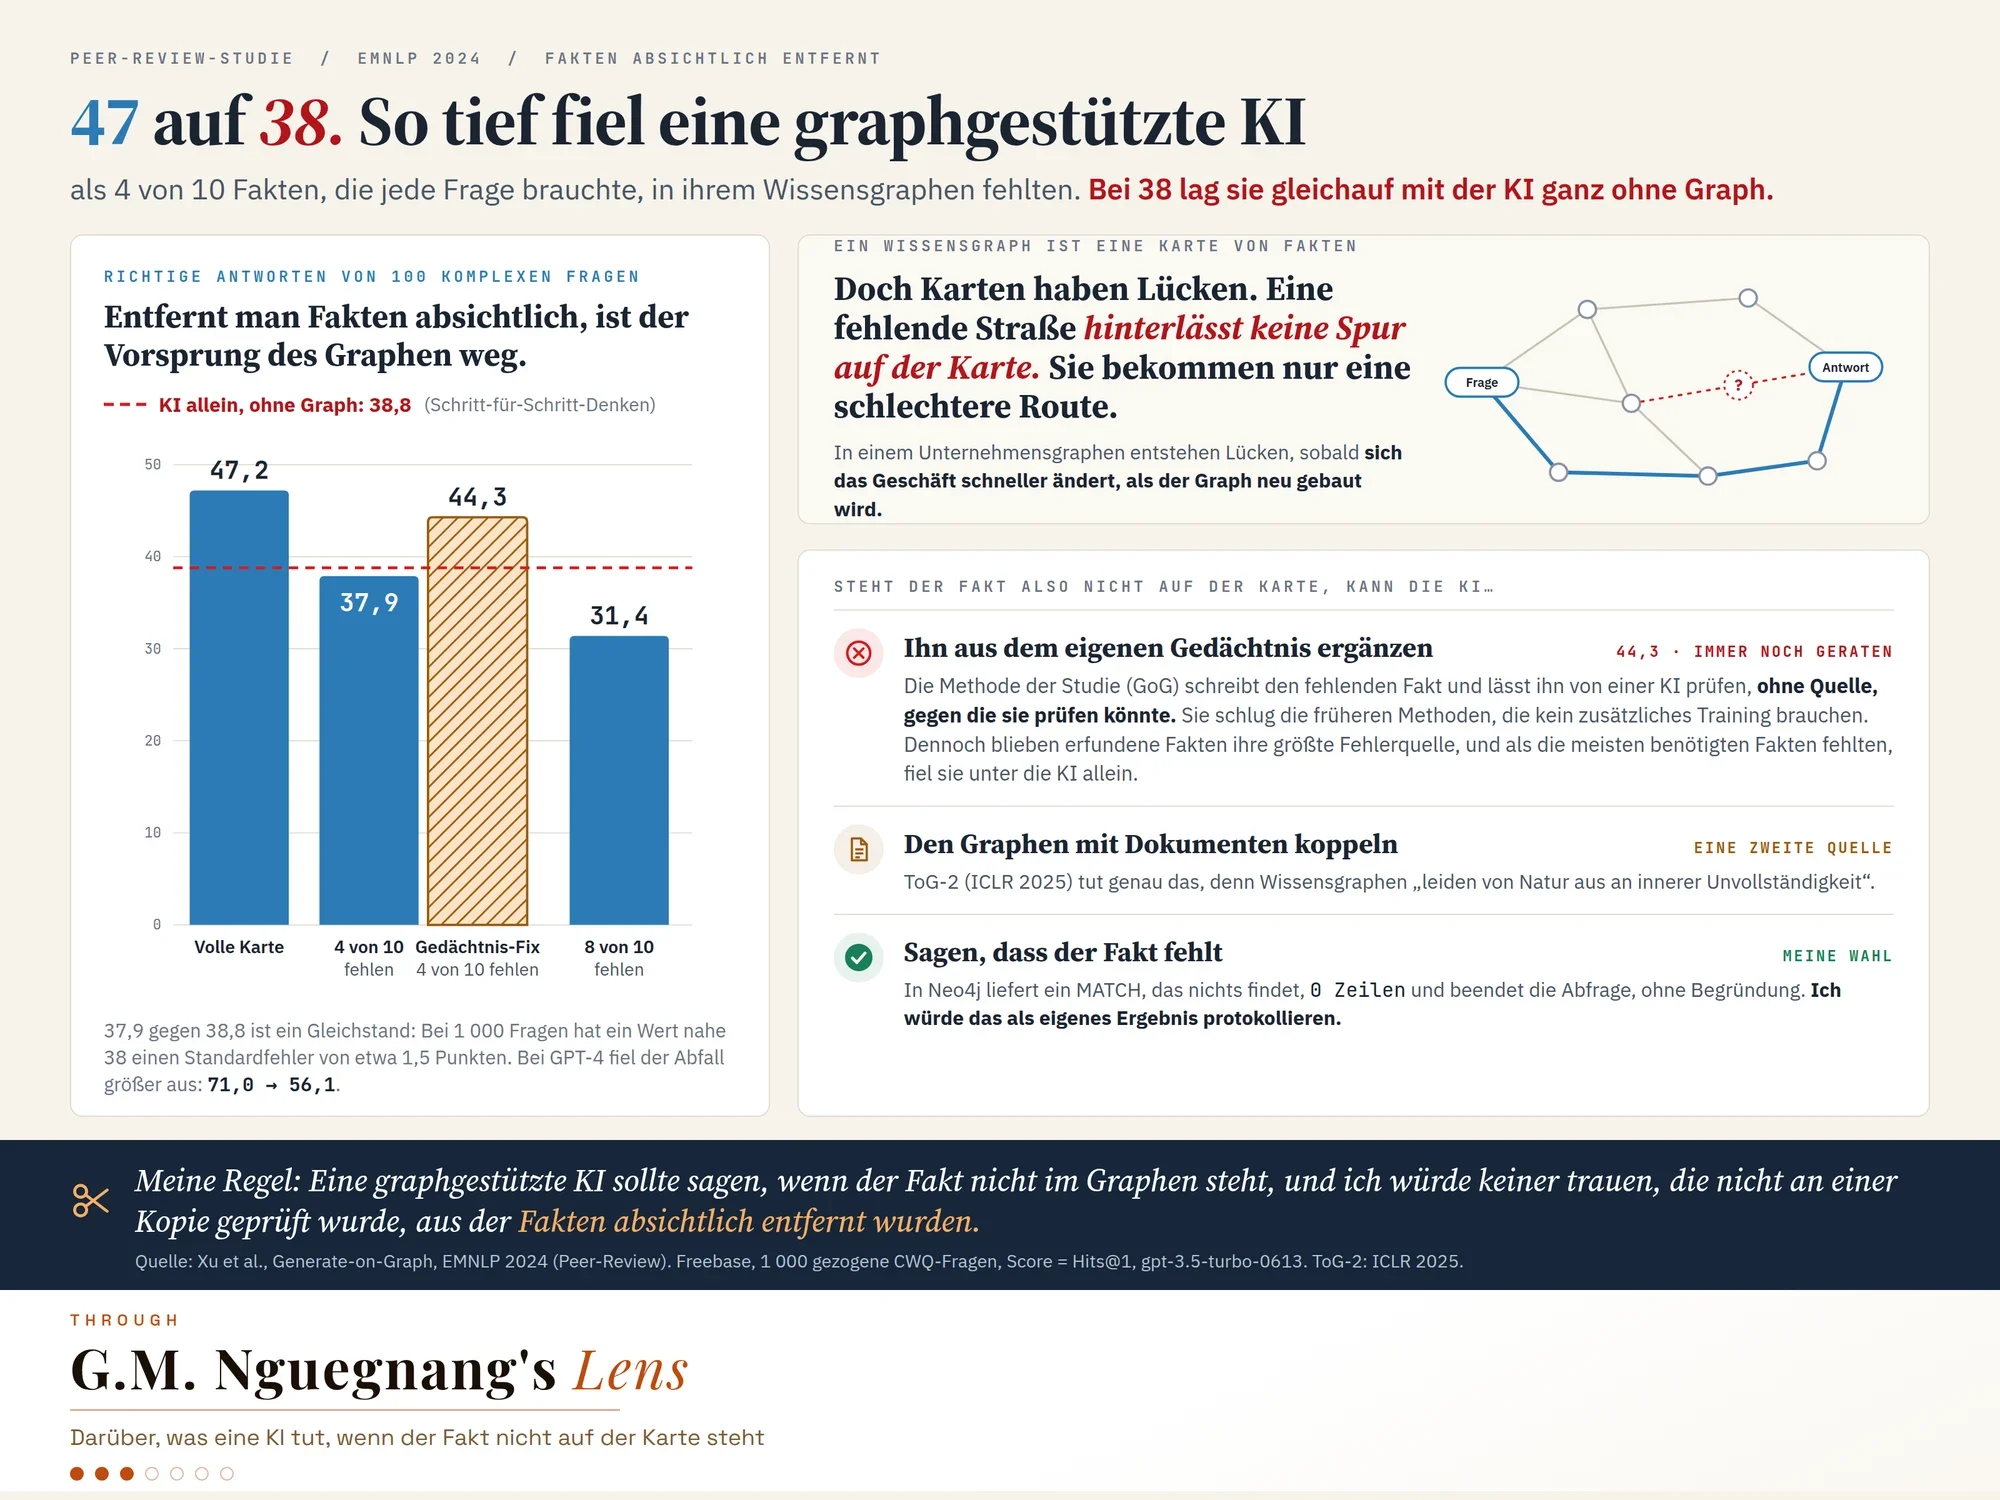
47 auf 38. So tief fiel eine graphgestützte KI, als 4 von 10 Fakten, die jede Frage brauchte, in ihrem Wissensgraphen fehlten. Bei 38 lag sie gleichauf mit der KI ganz ohne Graph.
Warum das zählt
Ein Wissensgraph ist eine Karte von Fakten und ihren Verbindungen. Das Versprechen lautet, dass die KI aus der Karte antwortet, statt zu raten.
Doch Karten haben Lücken. Eine fehlende Straße hinterlässt keine Spur auf der Karte. Sie bekommen nur eine schlechtere Route. In einem Unternehmensgraphen entstehen Lücken, sobald sich das Geschäft schneller ändert, als der Graph neu gebaut wird.
Eine begutachtete Studie entfernte Fakten absichtlich. Ein früheres Graphverfahren beantwortete mit der vollständigen Karte rund 47 von 100 komplexen Fragen richtig und 38, als 4 von 10 Schlüsselfakten fehlten. Die KI allein, Schritt für Schritt denkend, kam auf 39.
Das eigene Verfahren der Studie ergänzt einen fehlenden Fakt aus dem Gedächtnis der KI und lässt ihn von einer KI prüfen, ohne Quelle, gegen die sie prüfen könnte. Es schlug die früheren Verfahren, die kein zusätzliches Training brauchen. Dennoch blieben erfundene Fakten seine größte Fehlerquelle, und als die meisten benötigten Fakten fehlten, fiel es unter die KI allein.
Meine Regel daraus: Eine graphgestützte KI sollte sagen, wenn der Fakt nicht im Graphen steht, und ich würde keiner trauen, die nicht an einer Kopie geprüft wurde, aus der Fakten absichtlich entfernt wurden.
Wie es funktioniert
Generate-on-Graph (EMNLP 2024) entfernte 20 % bis 80 % der entscheidenden Tripel auf dem Referenzpfad jeder Frage, über Freebase, bei 1 000 gezogenen CWQ- und WebQSP-Fragen.
Bei CWQ Hits@1 erreichte Think-on-Graph 47,2 mit vollständigem Graphen, 37,9 bei 40 % Entfernung und 31,4 bei 80 %, auf gpt-3.5-turbo-0613. Auf gpt-4-0613 fiel der Abfall größer aus: von 71,0 auf 56,1. Schrittweises Denken ganz ohne Graph erreichte 38,8.
Wie ich 37,9 gegen 38,8 lese: als Gleichstand. Bei 1 000 Fragen trägt ein Wert nahe 38 einen Standardfehler von etwa 1,5 Punkten. Die Werte für schrittweises Denken entsprechen zudem exakt den ChatGPT-Zahlen des ToG-Papers, sie könnten also aus einem anderen Lauf stammen.
GoG lässt das Modell die fehlenden Tripel erzeugen und prüfen, womit es bei 40 % Entfernung 44,3 erreicht. Der eigene Abschnitt zu den Grenzen räumt Halluzinationen in diesem Schritt ein und einen Wert unter dem schrittweisen Denken bei sehr unvollständigen Graphen. ToG-2 (ICLR 2025) koppelt den Graphen stattdessen mit Dokumenten, denn Wissensgraphen „leiden von Natur aus an innerer Unvollständigkeit“.
Die technische Folge liegt eine Schicht tiefer. In Neo4j liefert ein MATCH, das nichts findet, keine Zeilen und beendet die Abfrage. Ein leeres Ergebnis trägt keine Begründung mit sich, und genau das ist das Signal, das die aufrufende Stelle braucht: Ich würde es als eigenes Ergebnis protokollieren, statt es als Schweigen durchgehen zu lassen.