3× la précision sur des questions métier, avec le même modèle
Des chercheurs ont posé 43 questions métier à GPT-4 sur un modèle de données d'assurance standard. Ce qui a fait passer la précision de 16,7 % à 54,2 % n'est pas le modèle. C'est ce qu'on lui a donné à lire.
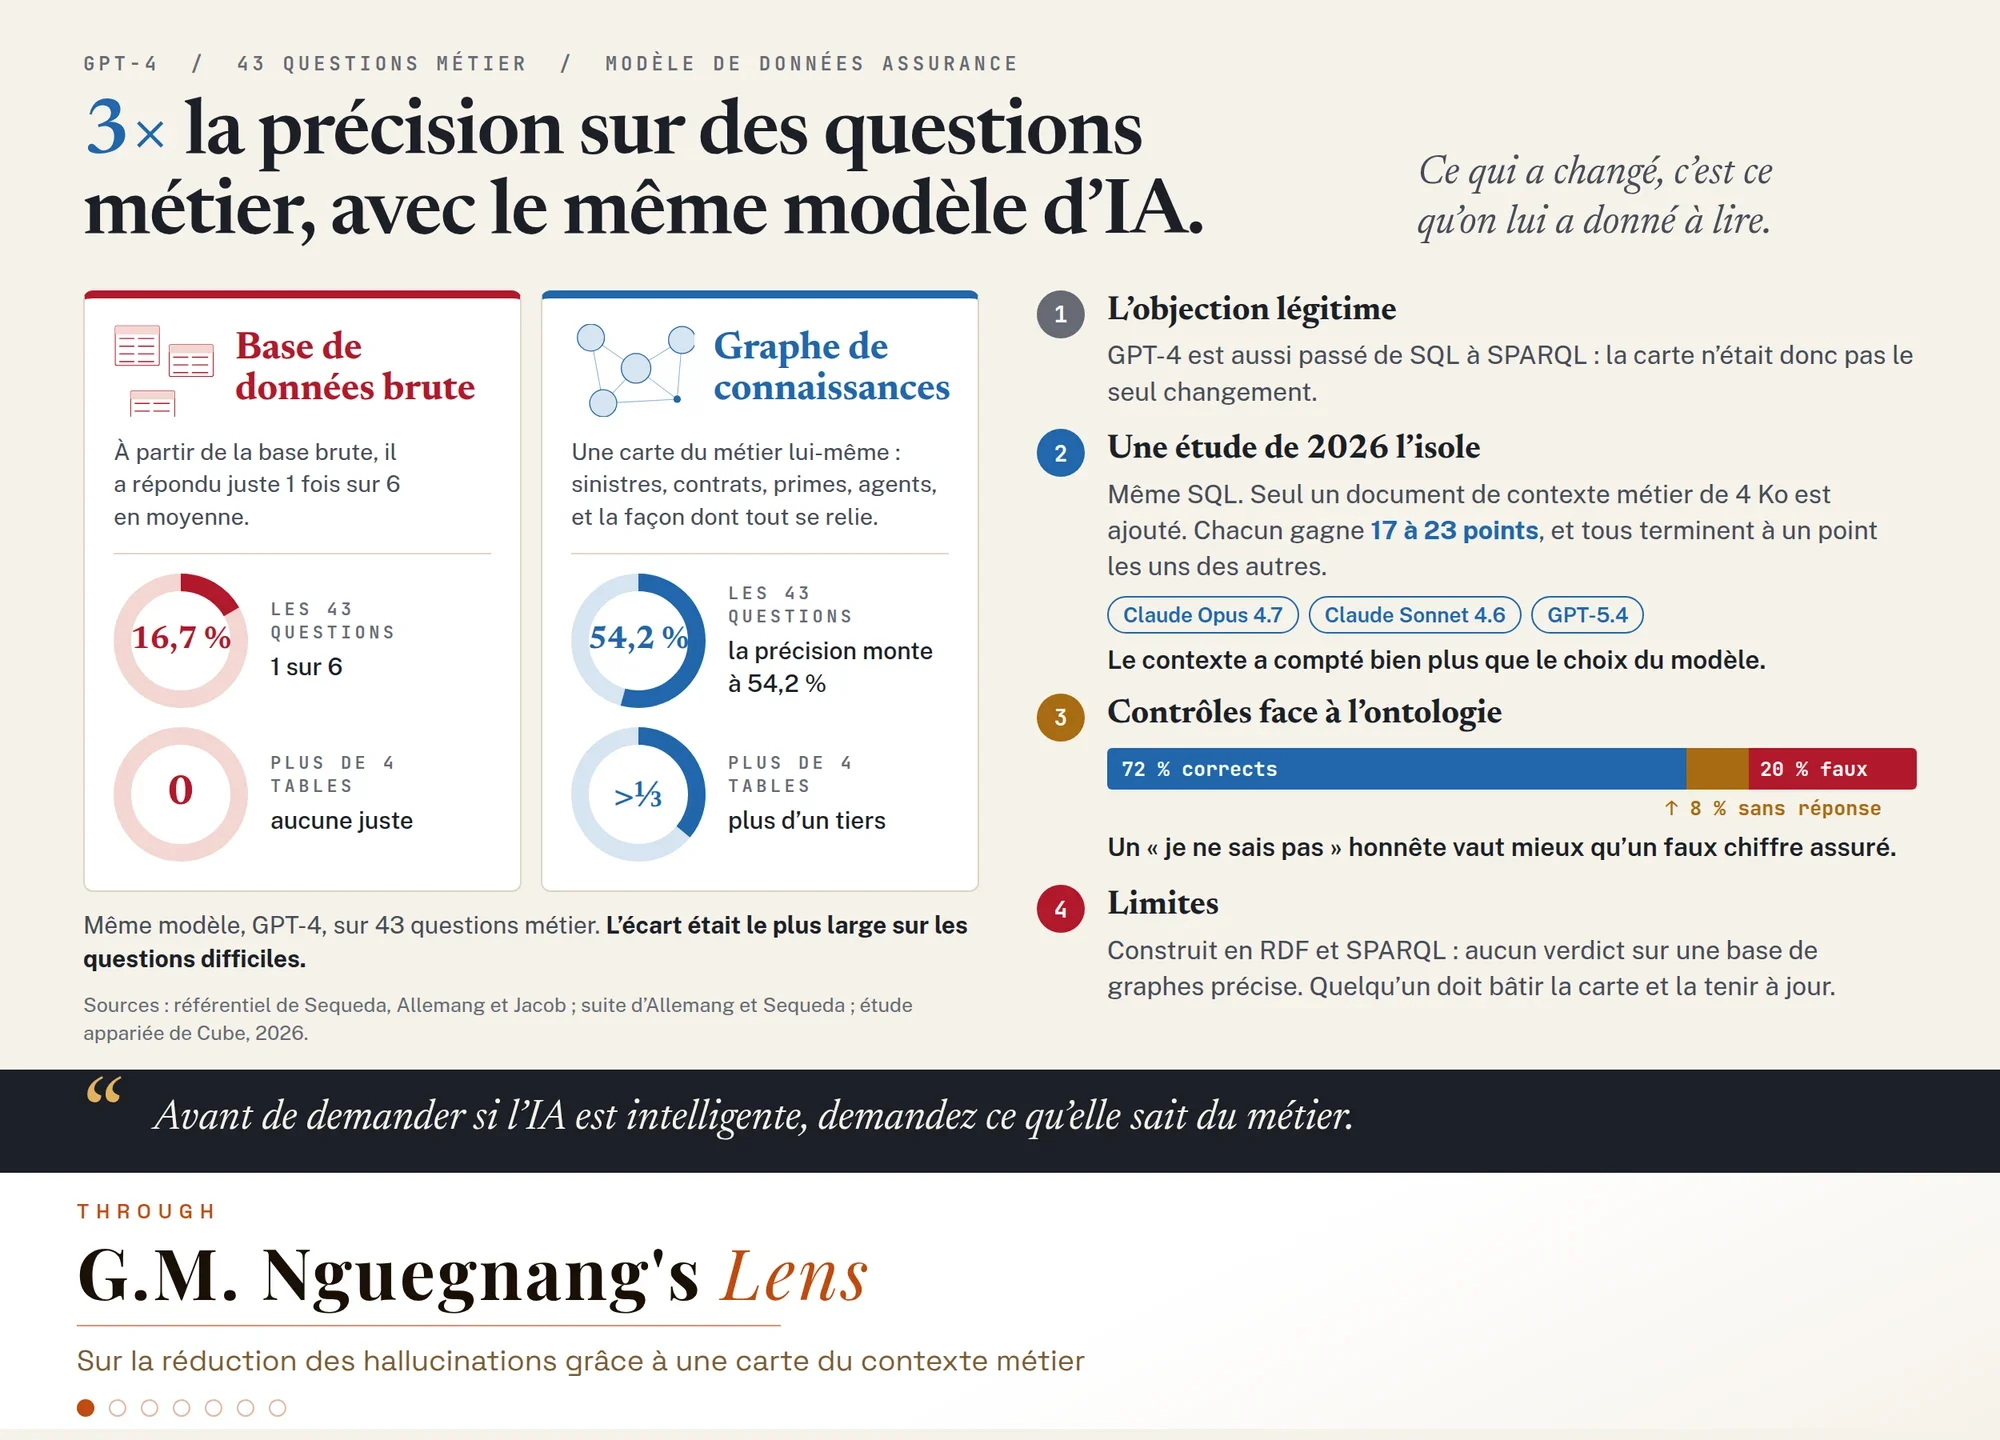
3× la précision sur des questions métier, avec le même modèle d’IA. Ce qui a changé, c’est ce qu’on lui a donné à lire.
Pourquoi cela compte
Des chercheurs ont posé à GPT-4 43 questions métier sur un modèle de données d’assurance standard du secteur. À partir de la base brute, il a répondu juste 1 fois sur 6 en moyenne.
Ils lui ont ensuite donné un graphe de connaissances : une carte du métier lui-même. Sinistres, contrats, primes, agents, et la façon dont tout se relie.
La précision est passée de 16,7 % à 54,2 %.
L’écart était le plus large sur les questions difficiles. Quand une réponse traversait plus de 4 tables, la configuration sur base brute n’en a obtenu aucune. Avec la carte, elle en a obtenu plus d’un tiers.
Avant de demander si l’IA est intelligente, demandez ce qu’elle sait du métier.
Comment cela fonctionne
Sequeda, Allemang et Jacob, qui ont bâti ce référentiel, soulèvent eux-mêmes l’objection légitime : GPT-4 est aussi passé de SQL à SPARQL, la carte n’était donc pas le seul changement.
Une étude appariée de 2026, menée par Cube, éditeur de couches sémantiques, isole la variable. SQL dans les deux conditions, et seul un document de contexte métier de 4 Ko varie. Claude Opus 4.7, Claude Sonnet 4.6 et GPT-5.4 gagnent chacun 17 à 23 points et, le document en main, terminent à un point les uns des autres. Dans cette étude, le contexte a compté bien plus que le choix du modèle. L’éditeur vend des couches sémantiques, donc le cadrage mérite la réserve d’usage ; c’est le protocole qui la rend utile, puisqu’une seule chose a bougé.
Une suite d’Allemang et Sequeda a ajouté des contrôles de requête face à l’ontologie : 72 % de réponses justes, 8 % de « je ne sais pas », 20 % de fausses. Un « je ne sais pas » honnête vaut mieux qu’un chiffre faux et assuré, parce que c’est le chiffre faux et assuré qui finit dans une présentation.
Deux limites méritent d’être dites clairement. Ce graphe utilisait RDF et SPARQL : le résultat ne dit donc rien d’une base de graphes en particulier. Et quelqu’un doit bâtir la carte et la tenir à jour : la précision arrive avec une facture de maintenance, et c’est la part que la plupart des pilotes oublient de chiffrer.