3× so genau bei Geschäftsfragen, mit demselben Modell
Forschende stellten GPT-4 43 Geschäftsfragen auf einem branchenüblichen Versicherungsdatenmodell. Was die Genauigkeit von 16,7 % auf 54,2 % hob, war nicht das Modell. Es war das, was das Modell zu lesen bekam.
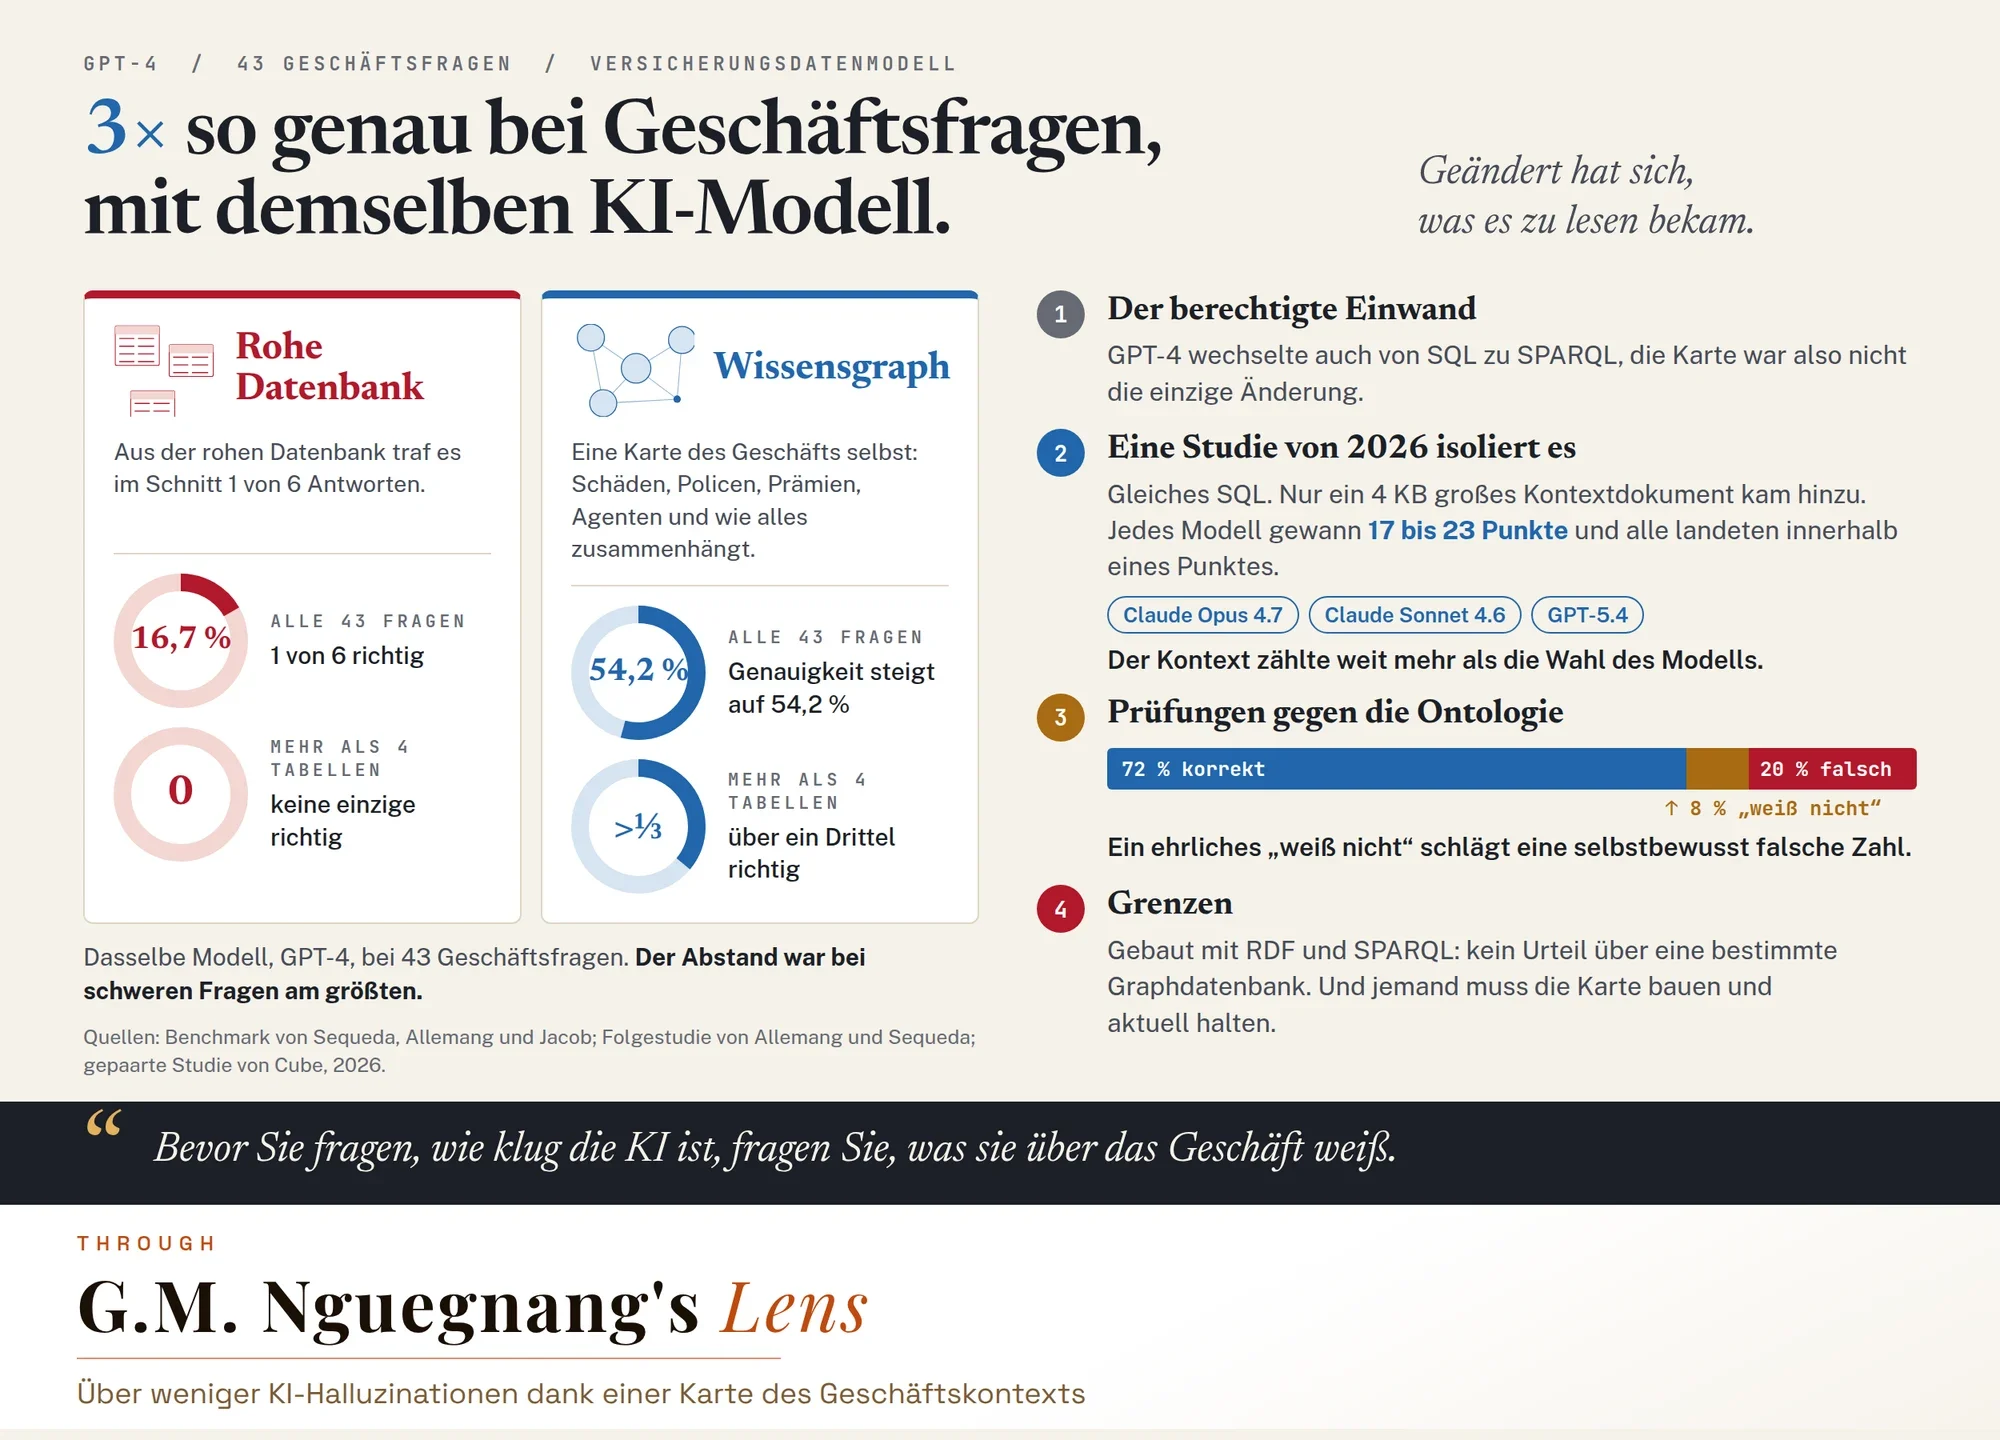
3× so genau bei Geschäftsfragen, mit demselben KI-Modell. Geändert hat sich, was es zu lesen bekam.
Warum das zählt
Forschende stellten GPT-4 43 Geschäftsfragen auf einem branchenüblichen Versicherungsdatenmodell. Aus der rohen Datenbank traf es im Schnitt 1 von 6 Antworten.
Dann gaben sie ihm einen Wissensgraphen: eine Karte des Geschäfts selbst. Schäden, Policen, Prämien, Agenten und wie alles zusammenhängt.
Die Genauigkeit stieg von 16,7 % auf 54,2 %.
Am größten war der Abstand bei den schweren Fragen. Sobald eine Antwort mehr als 4 Tabellen umspannte, traf die Variante auf der rohen Datenbank keine einzige. Mit der Karte traf sie über ein Drittel.
Bevor Sie fragen, wie klug die KI ist, fragen Sie, was sie über das Geschäft weiß.
Wie es funktioniert
Sequeda, Allemang und Jacob, die den Benchmark gebaut haben, bringen den berechtigten Einwand selbst vor: GPT-4 wechselte auch von SQL zu SPARQL, die Karte war also nicht die einzige Änderung.
Eine gepaarte Studie von Cube aus dem Jahr 2026, einem Anbieter semantischer Schichten, isoliert die Variable. SQL in beiden Bedingungen, und nur ein 4 KB großes Dokument mit Geschäftskontext kam hinzu. Claude Opus 4.7, Claude Sonnet 4.6 und GPT-5.4 gewannen jeweils 17 bis 23 Punkte und landeten mit dem Dokument innerhalb eines Punktes beieinander. In dieser Studie zählte der Kontext weit mehr als die Wahl des Modells. Der Anbieter verkauft semantische Schichten, die Rahmung verdient also den üblichen Abschlag; brauchbar macht sie der Aufbau, denn es bewegte sich nur eine Größe.
Eine Folgearbeit von Allemang und Sequeda ergänzte Abfrageprüfungen gegen die Ontologie: 72 % korrekt, 8 % „weiß nicht“, 20 % falsch. Ein ehrliches „weiß nicht“ schlägt eine selbstbewusst falsche Zahl, denn die selbstbewusst falsche Zahl ist die, die auf einer Folie landet.
Zwei Grenzen gehören klar benannt. Dieser Graph nutzte RDF und SPARQL, das Ergebnis sagt also nichts über eine bestimmte Graphdatenbank. Und jemand muss die Karte bauen und aktuell halten: Die Genauigkeit kommt mit einer Wartungsrechnung, und genau die vergessen die meisten Pilotprojekte einzupreisen.