Das Sicherheitsnetz beantwortete 32 von 150 Fragen aus dem falschen Dokument
Fand die Suche im richtigen Dokument nichts, durchsuchte mein System alles, damit Nutzer immer eine Antwort bekamen. Dieser Rückfallpfad machte aus einem sichtbaren Fehlschlag eine selbstbewusst falsche Antwort.
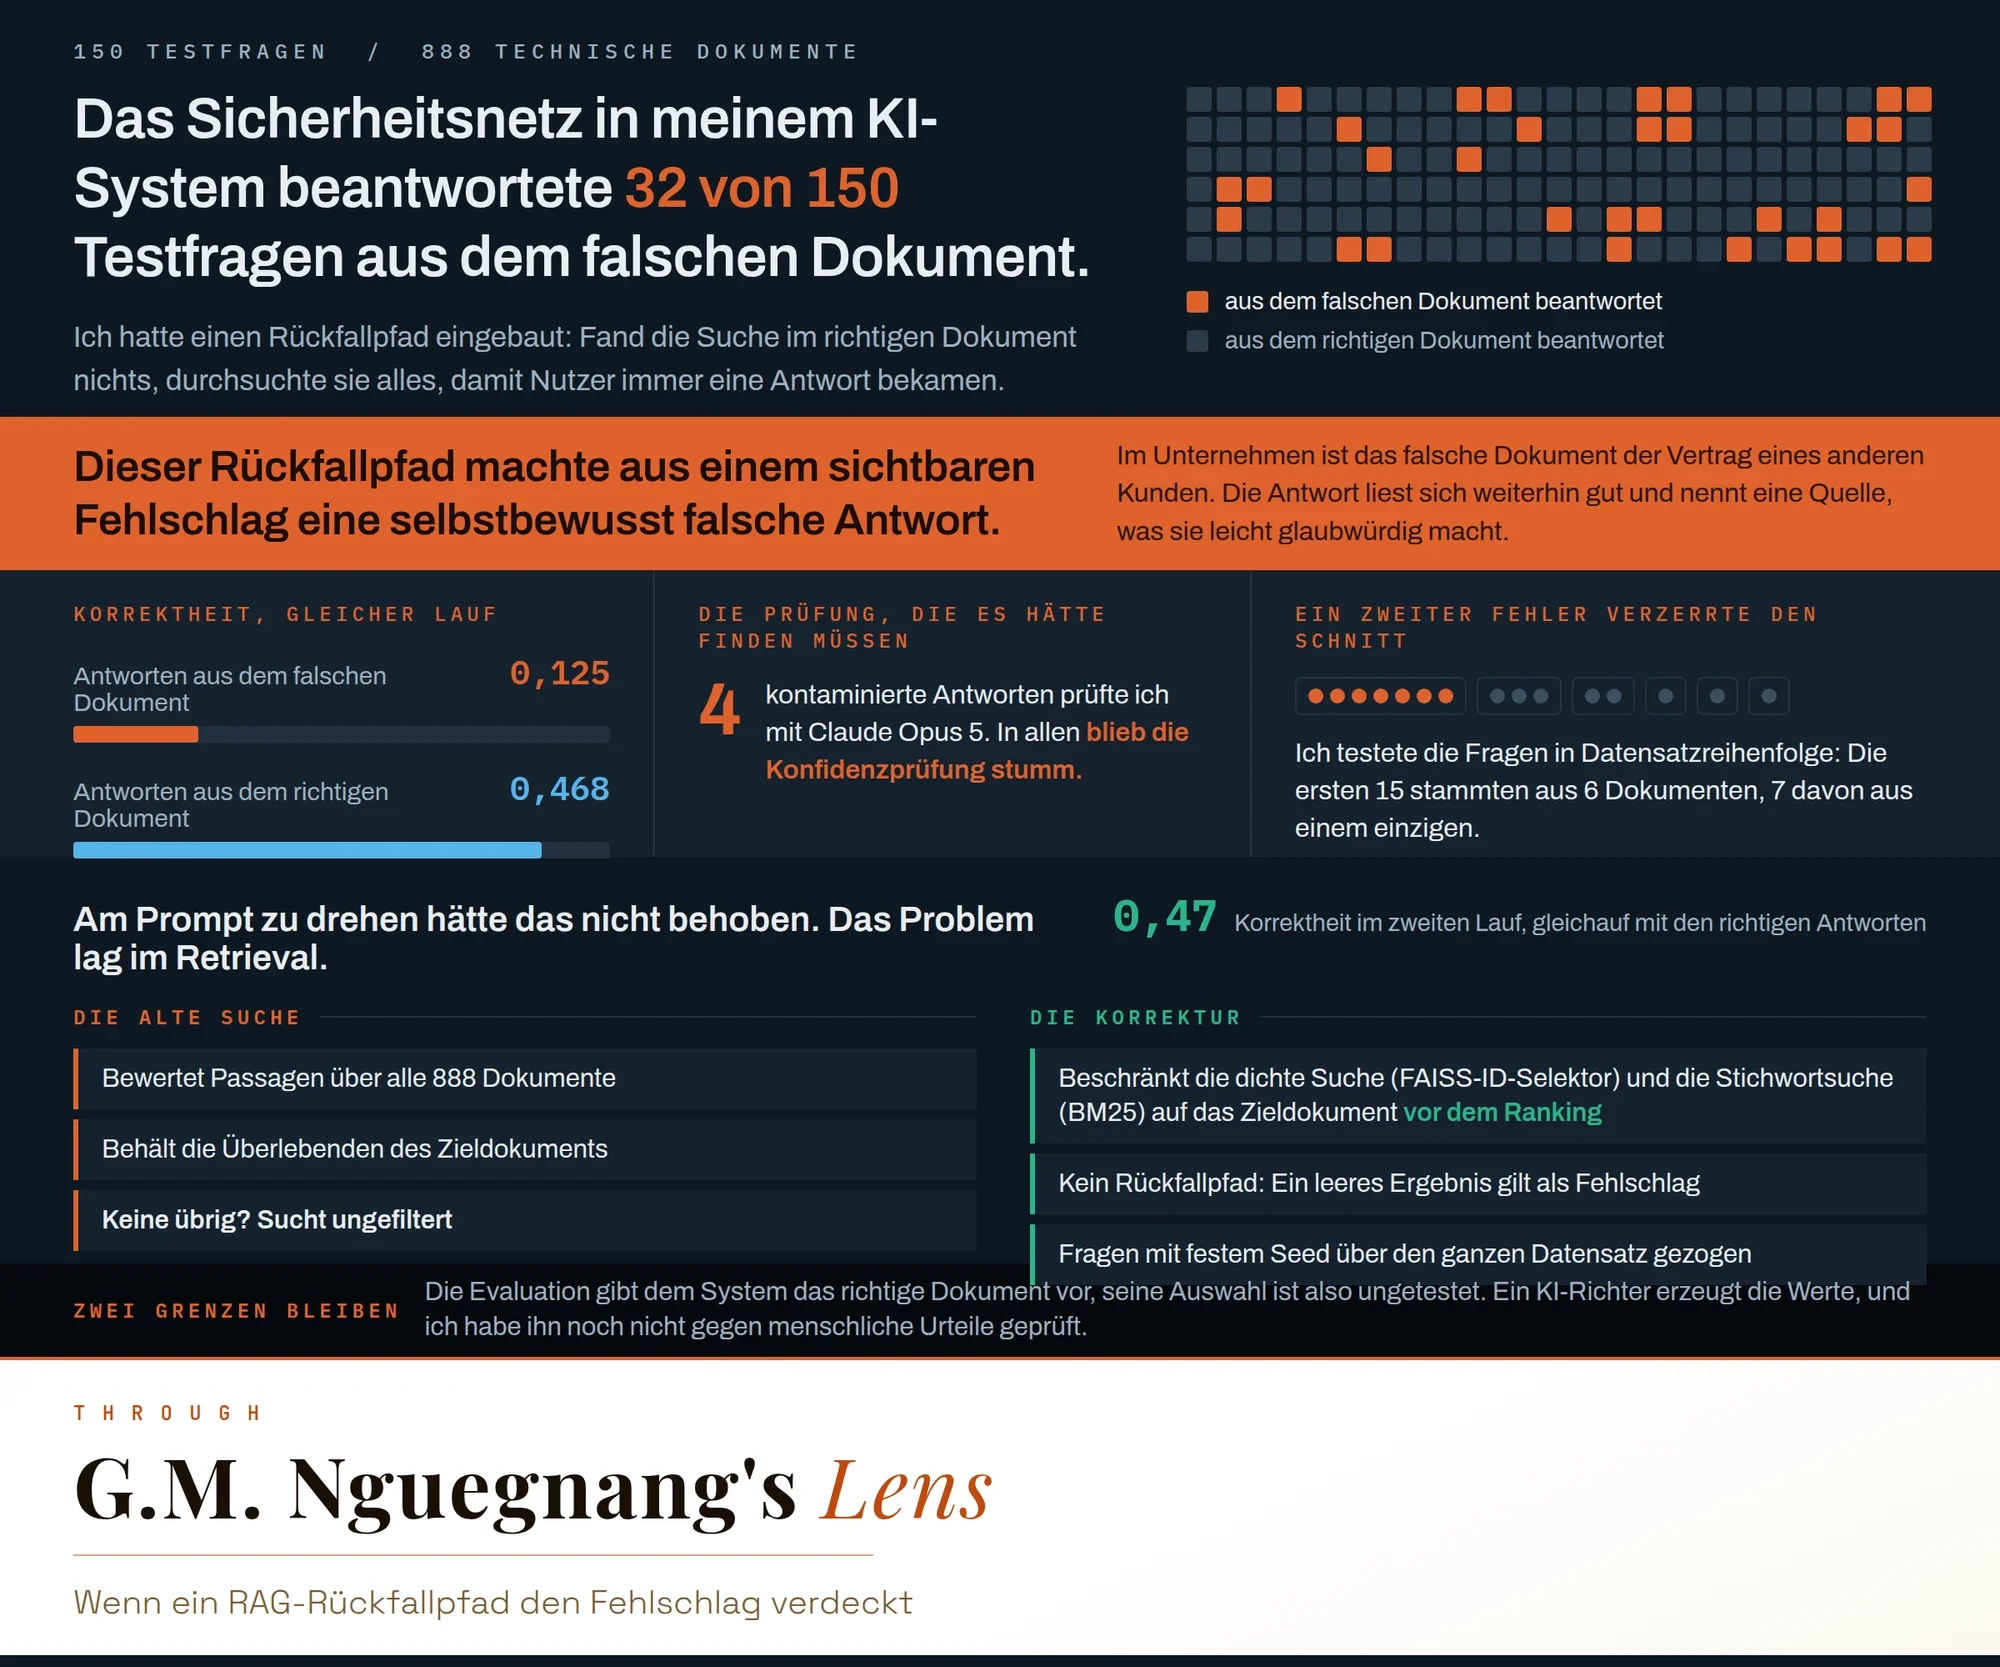
Das Sicherheitsnetz, das ich in mein KI-System eingebaut hatte, beantwortete 32 von 150 Testfragen aus dem falschen Dokument.
Warum das zählt
Das System beantwortet Fragen aus 888 technischen Dokumenten, mit Quellenangaben. Ich hatte einen Rückfallpfad eingebaut: Fand die Suche im richtigen Dokument nichts, durchsuchte sie alles, damit Nutzer immer eine Antwort bekamen.
Dieser Rückfallpfad machte aus einem sichtbaren Fehlschlag eine selbstbewusst falsche Antwort.
Im Unternehmen ist das falsche Dokument der Vertrag eines anderen Kunden. Die Antwort liest sich weiterhin gut und nennt eine Quelle, und genau das macht sie leicht glaubwürdig.
Meine Werte zeigten den Preis. Im selben Lauf erreichten Antworten aus dem falschen Dokument 0,125 Korrektheit, Antworten aus dem richtigen Dokument 0,468. In den 4 kontaminierten Antworten, die ich mit Claude Opus 5 prüfte, blieb die Konfidenzprüfung stumm.
Ein zweiter Fehler verzerrte den Schnitt: Ich testete die Fragen in Datensatzreihenfolge, und die ersten 15 stammten aus 6 Dokumenten, 7 davon aus einem einzigen.
Am Prompt zu drehen hätte das nicht behoben. Das Problem lag im Retrieval.
Wie es funktioniert
Die alte Suche bewertete Passagen über alle 888 Dokumente, behielt die Überlebenden des Zieldokuments und suchte ungefiltert weiter, wenn keine übrig blieb. Erst zu ranken und dann zu filtern ist in der Vektorsuche üblich, und genau dort bricht es: Bis der Filter greift, hat das Ranking seine Plätze längst an den Rest des Korpus vergeben.
Die Korrektur beschränkt die dichte Suche (ein FAISS-ID-Selektor) und die Stichwortsuche (BM25) vor dem Ranking auf das Zieldokument. Der Rückfallpfad ist weg: Ein leeres Ergebnis gilt als Fehlschlag, statt aus irgendeiner anderen Quelle beantwortet zu werden. Die Fragen werden jetzt mit festem Seed über den ganzen Datensatz gezogen, sodass die Mischung nicht mehr davon abhängt, wo die Datei beginnt.
Korrektheit im zweiten Lauf: 0,47, gleichauf mit den Antworten aus dem richtigen Dokument. Die 32 kontaminierten Antworten waren kein Generierungsproblem, an das ein besserer Prompt herangekommen wäre.
Zwei Grenzen bleiben, und beide muss ich selbst schließen. Die Evaluation gibt dem System das richtige Dokument vor, seine Auswahl ist also weiterhin ungetestet. Ein KI-Richter erzeugt die Werte, und ich habe ihn noch nicht gegen menschliche Urteile geprüft.