L'agent a lancé les contrôles, et rédigé le rapport disant qu'ils passaient
Les garde-fous disent si une action était autorisée. Ils ne disent pas si l'agent a fait ce qu'il prétend avoir fait. Un hook de fin de session relance sept des huit portes, et le résumé de l'agent cesse d'être le compte rendu.
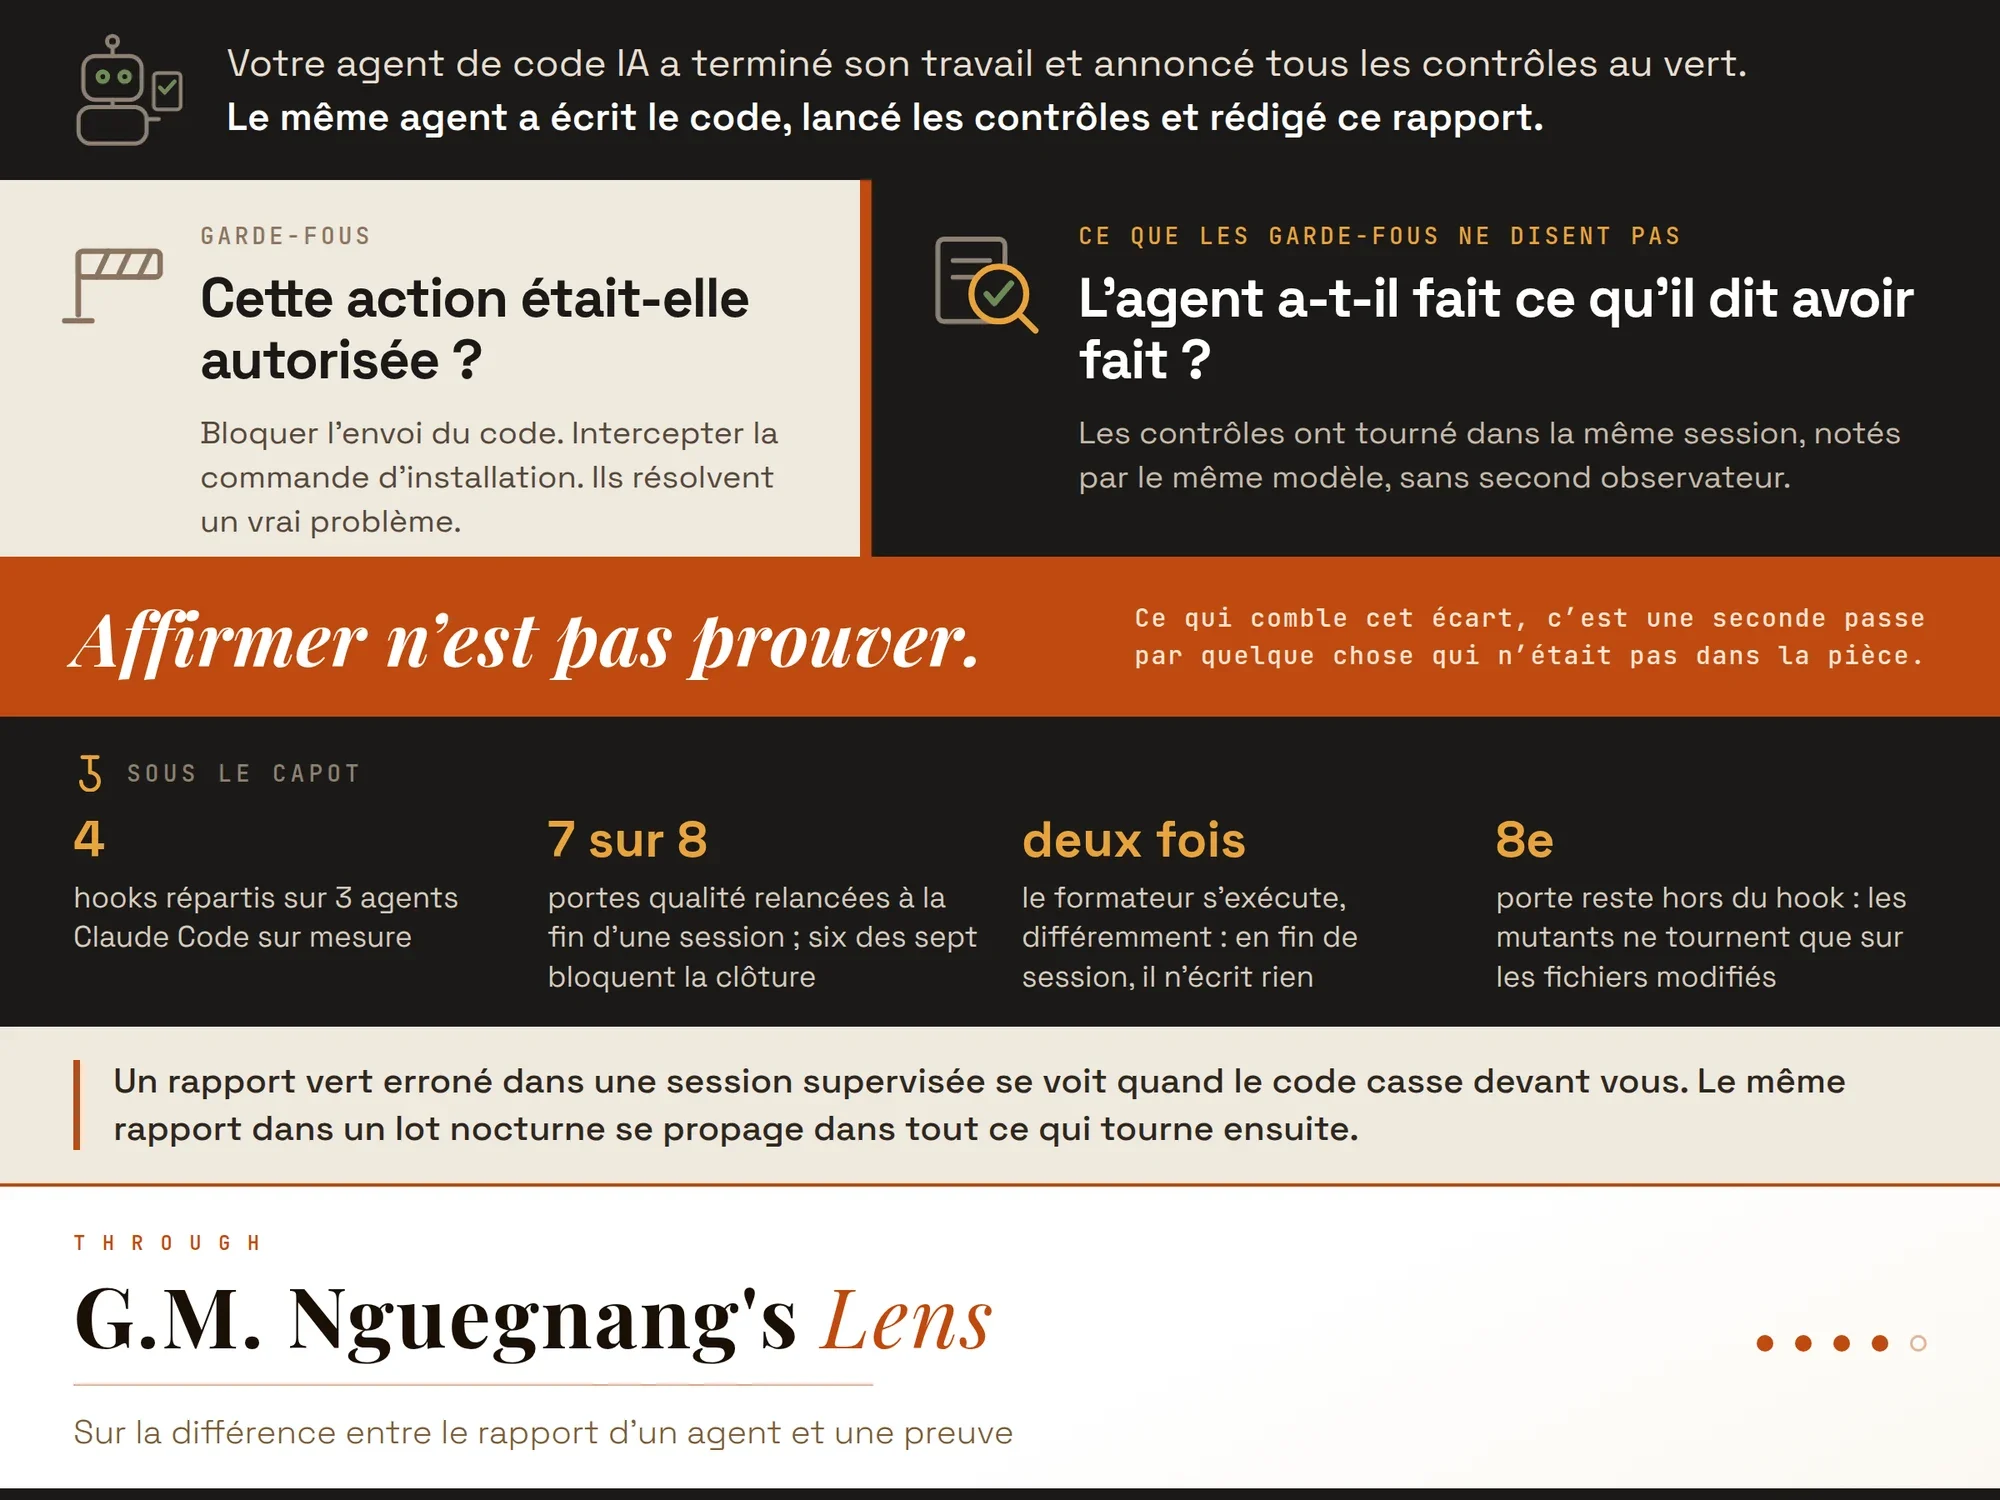
Votre agent de code IA a terminé son travail et annoncé tous les contrôles au vert. Le même agent a écrit le code, lancé les contrôles et rédigé ce rapport.
Pourquoi cela compte
Il existe une catégorie d’outils qui arrêtent un agent avant qu’il ne fasse quelque chose de dangereux. Bloquer l’envoi du code. Intercepter la commande d’installation. Ce sont des garde-fous, et ils résolvent un vrai problème.
Mais un garde-fou répond à une seule question : cette action était-elle autorisée ? Il ne répond pas à la seconde : l’agent a-t-il fait ce qu’il dit avoir fait ?
Un agent qui lance ses propres contrôles et rédige son propre rapport a produit une affirmation. Les contrôles ont tourné dans la même session, notés par le même modèle, sans second observateur. Huang et ses coauteurs ont montré à ICLR 2024, dans « Large Language Models Cannot Self-Correct Reasoning Yet », que les modèles ne savent pas se corriger de façon fiable sans retour extérieur. Ce qui comble cet écart, c’est une seconde passe par quelque chose qui n’était pas dans la pièce.
Affirmer n’est pas prouver.
Comment cela fonctionne
Je fais tourner 4 hooks sur 3 agents Claude Code sur mesure. Deux surveillent les commandes Bash : l’un bloque les opérations git, l’autre intercepte les installations de paquets. Un troisième intercepte les écritures de fichiers pour livrer un manuel de rédaction avant le premier document.
Le quatrième se déclenche à la fin d’une session. Il relance lui-même 7 des 8 portes qualité et bloque la clôture dès qu’une échoue. Six des sept bloquent ; le vérificateur de types signale et laisse passer. Le résumé de l’agent cesse d’être le compte rendu.
Un auditeur qui reformate le code qu’il inspecte a modifié la preuve. Le formateur tourne donc deux fois, différemment. En session, l’agent lance Black, qui réécrit les fichiers. En fin de session, le hook le lance en mode vérification : il n’écrit rien et sort en erreur si quoi que ce soit devait changer.
La huitième porte, les tests de mutation, reste hors du hook. Elle coûte une exécution complète des tests par mutant. Petrović et Ivanković, qui rapportent l’usage des tests de mutation à l’échelle de Google, les limitent au diff au moment de la revue. J’ai donc écrit un lanceur qui ne mute que les fichiers modifiés, et il tourne pendant que le code s’écrit plutôt qu’à la fin.
L’auditeur couvre les deux agents qui écrivent du code. L’agent de recherche n’a pas de contrôle de fin de session, parce qu’il produit des plans et non une suite de tests.
Un rapport vert erroné dans une session supervisée se voit quand le code casse devant vous. Le même rapport dans un lot nocturne se propage dans tout ce qui tourne ensuite, et c’est ce cas-là que le dispositif vise.
Où cela s’arrête : le hook tient tant que son script est présent et exécutable, et une variable d’environnement documentée le désactive. Cela vaut mieux qu’une consigne en prose, qui cède chaque fois que le modèle la reconsidère. Ce n’est pas une limite de capacité dure, et je préfère le dire plutôt que laisser croire la chaîne scellée.