Fünf Qualitätsgates bestanden, benotet vom Agenten, der den Code schrieb
Der Agent schrieb den Code, schrieb seine Tests, führte die Prüfungen aus und meldete fünfmal Grün. Nichts in der Pipeline war dafür gebaut zu fragen, wer den Prüfer prüft.
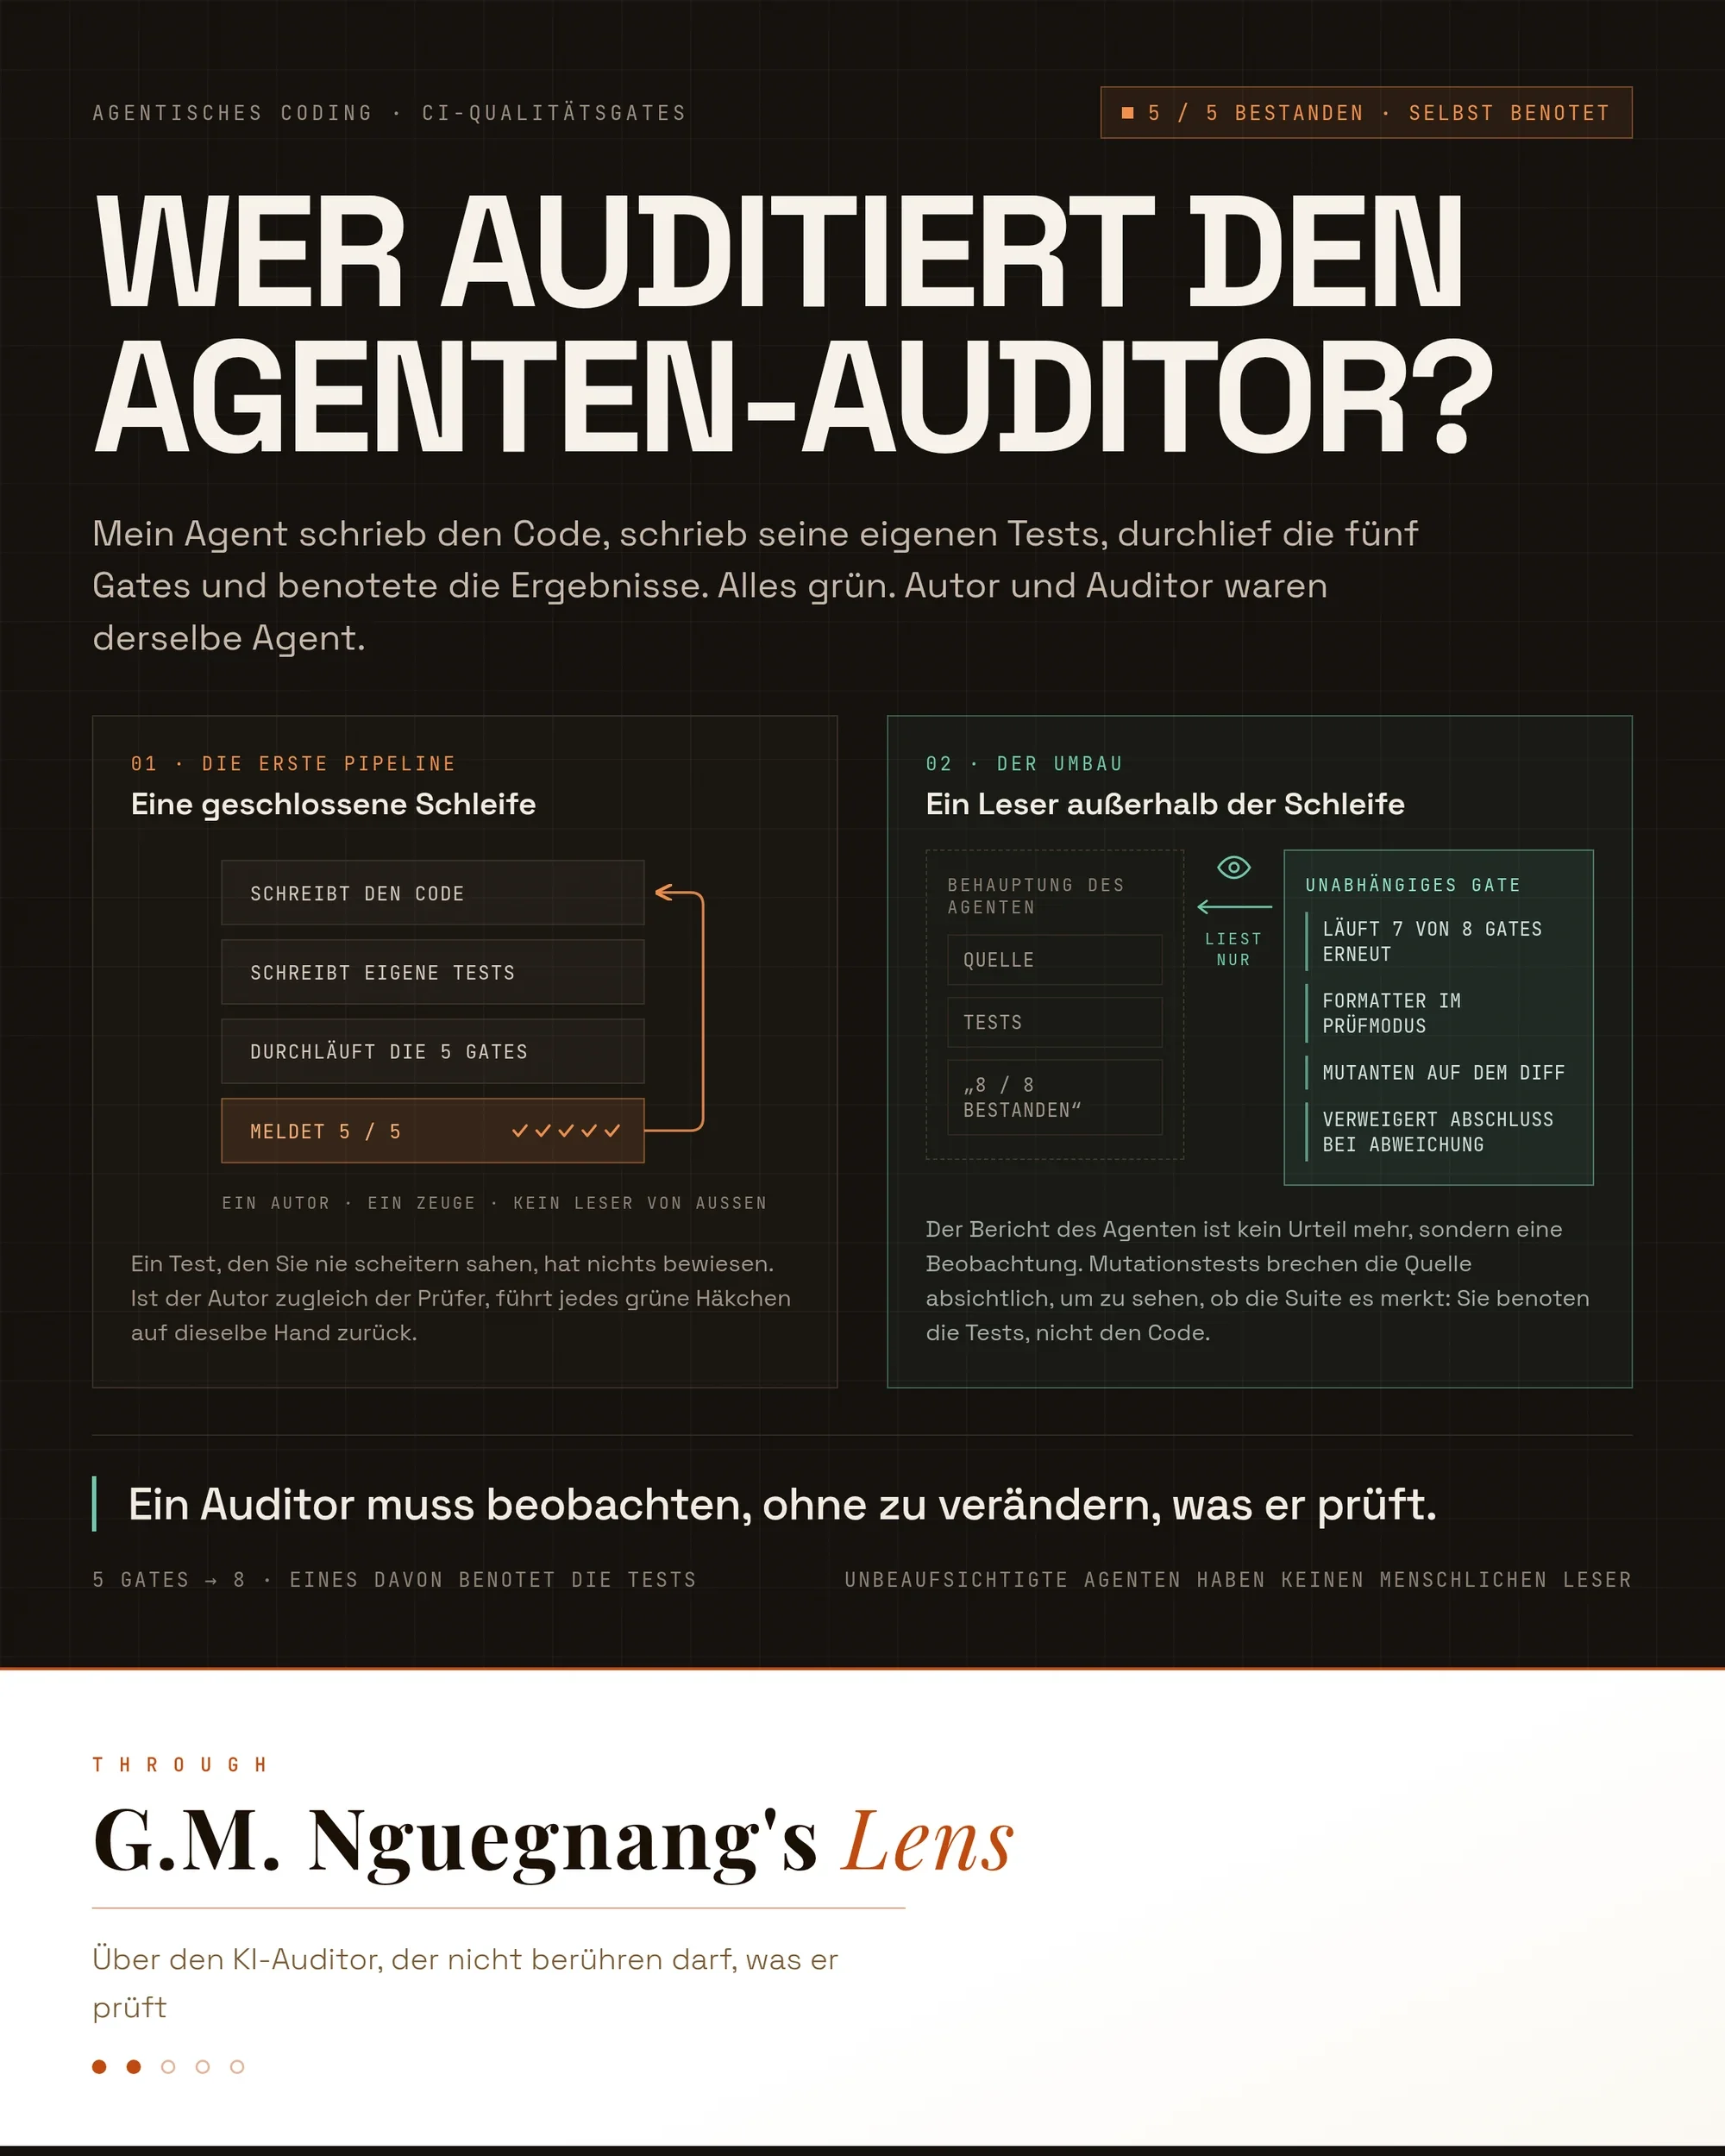
5 Qualitätsgates auf meinen KI-Coding-Agenten. Alle bestanden. Und alle benotet von dem Agenten, der den Code geschrieben hatte.
Warum das zählt
Der Agent schrieb den Code, schrieb seine Tests, führte die Prüfungen aus und meldete die Ergebnisse. Alle 5 grün. Nichts in der Pipeline war dafür gebaut zu fragen: Wer prüft den Prüfer?
Das klingt philosophisch, bis Ihr Agent einen Test schreibt, der einem Fehler zustimmt. Der Test besteht. Das Gate meldet Bestanden. Der Mensch sieht Grün. Und niemand bemerkt es, weil der einzige Zeuge derjenige war, der es geschrieben hat.
Auf der NeurIPS 2024 vorgestellte Arbeiten fanden, dass Sprachmodelle ihre eigenen Texte wiedererkennen und sie höher bewerten, weil sie sie wiedererkennen. Meine Pipeline trug diese Verzerrung in ihrer Bewertungsschleife, ohne eine Möglichkeit, sie zu sehen.
Ein Auditor muss beobachten, ohne zu verändern, was er prüft.
Wie es funktioniert
Drei eigene Claude-Code-Agenten: Recherche, Bau, Prüfung. Die erste Fassung durchlief 5 Gates vor jedem Commit. Vier bestätigten Syntax, Stil, Typen und Schwachstellenmuster. Das fünfte war pytest, das Tests benotete, die derselbe Agent geschrieben hatte.
Ein Test, den Sie nie scheitern sahen, hat nichts bewiesen. Dieser Satz trieb den Umbau. Ich ergänzte drei Gates, die die ersten fünf nicht sehen konnten. Das hier entscheidende sind die Mutationstests: Sie brechen die Quelle absichtlich, um zu prüfen, ob die Suite es merkt, und benoten damit die Tests statt den Code.
Dann die schwierigere Hälfte. Endet eine Sitzung, führt ein Stop-Hook 7 der 8 Gates erneut aus und verweigert den Abschluss bei einer Abweichung, sodass der Bericht des Agenten zur Beobachtung wird statt zum Urteil. Der Formatter läuft dort im Prüfmodus und schreibt nichts: Ein Auditor, der den Code umformatiert, hat den Beleg verändert.
Die Mutationstests sind das achte Gate, und der Hook führt sie nicht erneut aus. Den ganzen Baum zu mutieren kostet einen Lauf der Testsuite pro Mutant. Google beschränkt sie aus diesem Grund zur Review-Zeit auf den Diff, und ich habe ein Skript geschrieben, das dasselbe tut.
Ein Mensch an einer Sitzung fängt einen falschen grünen Bericht ab. Agenten, die unbeaufsichtigt oder parallel laufen, haben keinen solchen Leser, und für diesen Fall lohnt sich der Aufbau.
Wo das endet: Einer meiner drei Agenten kann weiterhin ungehindert Pakete installieren. Committen, pushen oder taggen kann er nicht, der Schadensradius ist also eine kaputte Umgebung und kein veröffentlichter Fehler.